

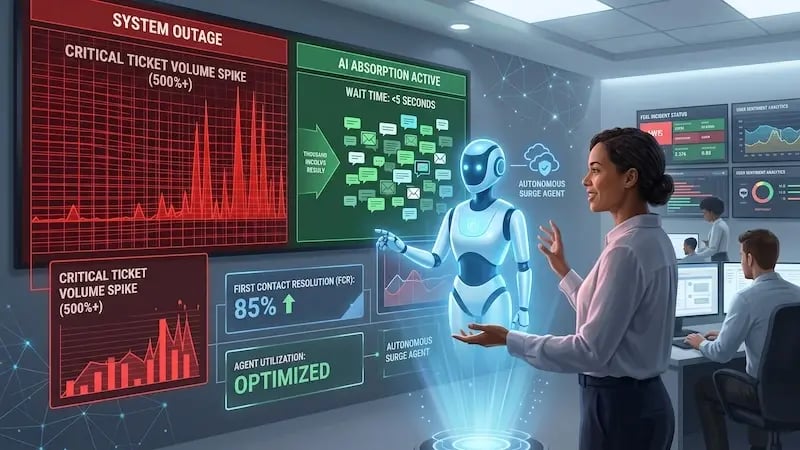
Imaginați-vă următorul scenariu: este ora 14:15 într-o marți, iar platforma dvs. principală de cloud suferă o întrerupere neașteptată a bazei de date. În decurs de 120 de secunde, numărul tichetelor de asistență primite crește cu 800%. Coada de așteptare pentru chatul live sare de la un timp de așteptare normal de 3 minute la un volum de așteptare epuizant de 4 ore. Căsuțele de e-mail se umplu cu întrebări repetate, iar canalele de socializare sunt inundate de utilizatori frustrați care pun exact aceeași întrebare: „Sistemul nu funcționează?”
 Cum reacționează echipa dvs. de asistență atunci când o criză tehnică bruscă vă copleșește operațiunile?
Pentru majoritatea operațiunilor întreprinderilor, o întrerupere majoră reprezintă un coșmar operațional. Reprezentanții de asistență sunt copleșiți instantaneu de mii de tichete identice. Timpii de răspuns se prăbușesc, satisfacția clienților (CSAT) scade vertiginos, iar echipa dvs. ajunge la epuizare încercând să rezolve manual un volum de solicitări restante care crește mai repede decât pot tasta.
Aici se prăbușește infrastructura tradițională de servicii pentru clienți. Răspunsurile automate statice eșuează deoarece nu oferă actualizări în timp real. În același timp, echipele formate exclusiv din oameni pur și simplu nu se pot adapta instantaneu pentru a absorbi o creștere a volumului de 1.000% fără a genera costuri operaționale masive.
Pentru a gestiona crizele de sistem fără a afecta indicatorii operaționali, aveți nevoie de un sistem de răspuns elastic și inteligent. Implementarea agenților autonomi pentru vârfuri de trafic oferă o modalitate modernă de a transforma modul în care organizațiile enterprise gestionează vârfurile neașteptate de trafic, protejează fluxurile de asistență în timp real și mențin încrederea în timpul întreruperilor cu miză mare.
Ce se întâmplă în timpul unui val de incidente?
Atunci când un server, o API sau o platformă software suferă o întrerupere, impactul se propagă rapid de la departamentul de inginerie la departamentul de operațiuni și la departamentul de relații cu clienții. În timp ce inginerii de fiabilitate a site-ului (SRE) se grăbesc să remedieze cauza principală, echipele de asistență pentru clienți suportă greul panicii utilizatorilor.
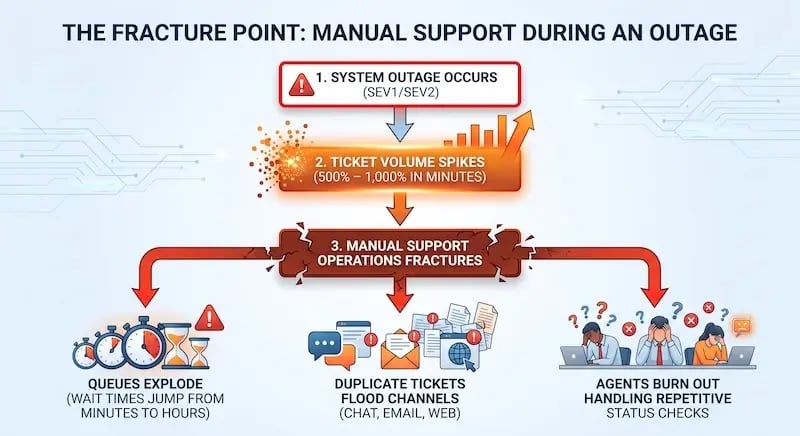
De ce sistemele tradiționale de asistență cedează atât de repede sub greutatea unui incident? Răspunsul rezidă în modul în care fluxurile de lucru vechi gestionează vârfurile de trafic.
1. Avalanșa de tichete duplicate
Atunci când utilizatorii nu primesc un răspuns imediat pe un canal, rareori așteaptă cu răbdare.
De fapt, cercetările arată că
56% dintre clienți trec imediat la un al doilea canal de asistență atunci când contactul inițial nu se încadrează în intervalul de răspuns rapid, iar 75% încearcă să ia legătura de două sau trei ori înainte de a aștepta.
În timpul unei întreruperi neașteptate a sistemului, acest comportament determină creșterea exponențială a volumului de tichete primite, deoarece un singur client care se confruntă cu o problemă timp de 10 minute creează 3 sau 4 tichete duplicate prin chat, e-mail și rețelele sociale.
2. Costul devierii statice
Platformele tradiționale de asistență se bazează pe răspunsuri automate statice sau pe alerte generice sub formă de bannere. Deși aceste instrumente confirmă existența unei probleme, ele oferă rareori detalii specifice contului sau răspunsuri definitive. Clienții consideră mesajele statice tactici de redirecționare inutili. Drept urmare, aceștia ignoră bannerul și trimit oricum un tichet.
3. Costurile financiare și operaționale
Timpii de nefuncționare neplanificați implică costuri financiare semnificative pentru organizațiile moderne.
Cercetările arată că,
perioadele de nefuncționare neplanificate ale sistemelor IT costă marile organizații, în medie, 15.000 de dolari pe minut.
Dacă se adaugă cheltuielile operaționale legate de gestionarea unui număr mai mare de tichete, impactul financiar crește semnificativ.
Gartner raportează că
interacțiunile de asistență cu suport live costă în medie 13,50 dolari pe interacțiune, comparativ cu doar 1,84 dolari pentru canalele automatizate de autoservire.
Atunci când 10.000 de utilizatori solicită asistență în timpul unei întreruperi de două ore, recurgerea la trierea manuală a solicitărilor poate costa peste 130.000 de dolari doar în operațiunile de asistență — totul pentru a răspunde la întrebări simple și repetitive privind starea sistemului.

Problema nu este doar de natură financiară. Atunci când agenții umani își petrec 80% din timp răspunzând la întrebări simple privind starea serviciului, clienții corporativi de mare valoare, cu probleme complexe, rămân blocați exact în aceeași coadă de așteptare. Acest lucru creează tensiuni grave acolo unde afacerea dumneavoastră își permite cel mai puțin.
Ce sunt agenții autonomi pentru vârfuri de solicitare?
Un agent autonom pentru vârfuri de solicitare este un sistem avansat de inteligență artificială (IA) conceput pentru a gestiona creșteri masive și neașteptate ale volumului de solicitări de asistență. Spre deosebire de chatboturile tradiționale, care se bazează pe arbori de decizie rigizi, agenții autonomi pentru vârfuri de solicitare utilizează înțelegerea limbajului natural (NLU), integrări dinamice ale sistemelor și declanșatoare de evenimente în timp real pentru a rezolva independent solicitările complexe ale clienților.
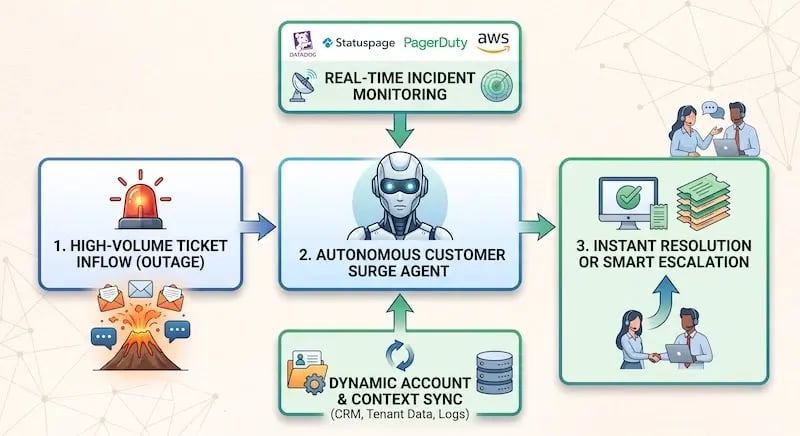 Acești agenți AI funcționează discret alături de motorul dvs. de asistență în timpul operațiunilor normale. Cu toate acestea, atunci când viteza de generare a tichetelor depășește un prag specific — cum ar fi o creștere de 300% a mesajelor primite în decurs de 5 minute — agentul autonom pentru vârfuri de trafic se activează automat pentru a absorbi volumul de solicitări.
Capacități cheie ale agenților autonomi de gestionare a vârfurilor de solicitare
| Caracteristică | Chatboți tradiționali | Agenți autonomi pentru vârfuri de trafic |
| Activare | Întotdeauna activi, cu scripturi fixe | Activare flexibilă, bazată pe viteza traficului în timp real |
| Acces la date | Bază de cunoștințe statică cu întrebări frecvente | Conexiuni API în timp real la instrumentele de monitorizare a sistemului și de verificare a stării |
| Context | Potrivire de bază a cuvintelor-cheie | Context la nivel de cont (ID-ul tenantului, nivelul de abonament, starea sistemului) |
| Rezoluție | Redirecționează utilizatorii către articole | Rezolvă solicitările de la un capăt la altul și oferă actualizări precise privind starea |
| Escaladare | Transfer generic către agenții care lucrează în timp real | Rutare inteligentă bazată pe sentimentul clientului și prioritatea VIP |
Cum funcționează agenții Surge în timp real
Luați în considerare ce se întâmplă atunci când un furnizor SaaS se confruntă cu o defecțiune internă a API-ului:
-
Detectare și declanșare: Platforma de asistență detectează un aflux brusc de tichete care conțin cuvinte-cheie „eroare de conexiune” sau„pagină 404”. Agentul autonom de vârf se inițializează în mai puțin de 5 secunde.
-
Verificare bazată pe context: agentul de vârf se conectează direct la instrumente interne de monitorizare precum Datadog, Statuspage sau PagerDuty. Acesta verifică dacă există un incident SEV1 activ pentru regiunea specifică a serverului utilizatorului.
-
Personalizare la nivel de cont: Când un utilizator deschide un chat, agentul de gestionare a vârfurilor de trafic citește contextul de autentificare și ID-ul tenant al utilizatorului. În loc să ofere un răspuns generic, acesta spune: „Bună, Sarah. Observăm că spațiul tău de lucru principal de pe Serverul East-2 se confruntă în prezent cu o întrerupere a API-ului. Echipa noastră de ingineri lucrează la remedierea problemei și ne așteptăm ca sistemele să revină la normal în 35 de minute.”
-
Rezolvare instantanee: Agentul întreabă utilizatorul dacă dorește o notificare automată imediat ce sistemul este repus în funcțiune. Odată ce utilizatorul acceptă, agentul înregistrează preferința și închide tichetul.
Prin gestionarea instantanee a acestor interacțiuni legate de stare,
agentul autonom de vârf poate rezolva până la 85% din tichetele legate de întreruperi fără intervenție umană.
Cum protejează agenții autonomi de vârf indicatorii cheie ai experienței clientului
În timpul unei crize operaționale, menținerea încrederii clienților depinde în mare măsură de rapiditatea și de claritatea comunicării. O întrerupere a serviciului este frustrantă, dar o comunicare deficitară în timpul acesteia este ceea ce îi determină pe clienți să plece definitiv.
Un sondaj realizat de Xurrent în rândul consumatorilor arată că
35% dintre consumatori contactează serviciul de asistență în timpul unei întreruperi a serviciilor digitale, în timp ce alți 34% sunt nevoiți să caute singuri informații actualizate atunci când canalele de comunicare nu funcționează.
Dacă acești clienți se confruntă cu timpi lungi de așteptare sau cu răspunsuri nefolositoare, rata de abandon crește rapid.
Iată cum agenții autonomi specializați în gestionarea vârfurilor de solicitare protejează indicatorii cheie operaționali și de experiență ai clienților în timpul unui incident.
1. Menținerea timpului de prim răspuns (FRT)
În timpul unui val major de solicitări, cozile standard de asistență în timp real se blochează, ceea ce duce la creșterea timpului de primă reacție de la 45 de secunde la câteva ore. Agenții autonomi pentru gestionarea vârfurilor de solicitare răspund în mai puțin de 5 secunde, indiferent dacă 50 sau 50.000 de clienți trimit solicitări simultan. Acest răspuns imediat reduce anxietatea utilizatorilor și îi împiedică pe oameni să trimită solicitări duplicate pe alte canale.
2. Protejarea ratei de rezolvare la primul contact (FCR)
Standardele din industrie arată că,
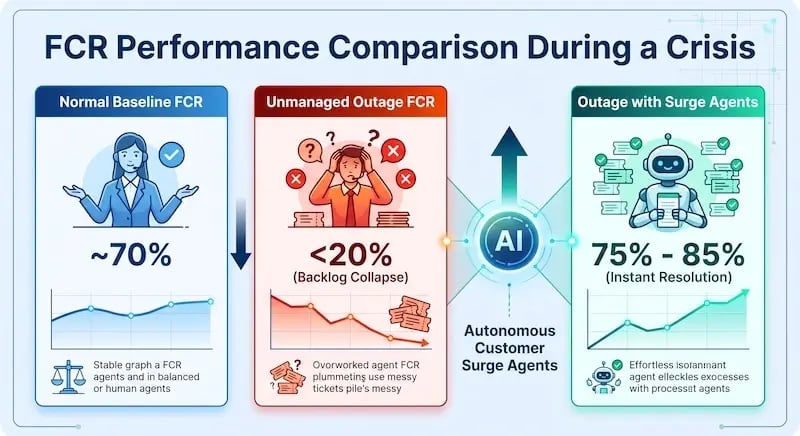
ratele normale de rezolvare la primul contact se situează în jur de 70% pentru echipele cu performanțe ridicate.
În timpul unei întreruperi necontrolate, FCR poate scădea sub 20%, deoarece reprezentanții sunt copleșiți și promit urmăriri pe care nu le pot monitoriza. Agenții autonomi de urgență mențin un FCR ridicat, oferind răspunsuri precise, în timp real, chiar de la primul contact.
3.Prevenirea pierderii clienților în fluxurile de asistență live
Când sistemele se blochează, frustrarea clienților crește rapid.
Cercetările indică faptul că
33% dintre clienți vor schimba furnizorul după o singură întrerupere a serviciului însoțită de o comunicare deficitară.
În plus,
32% dintre utilizatori renunță la o marcă după două sau trei probleme recurente legate de serviciu.
Agenții autonomi specializați în gestionarea vârfurilor de trafic ajută la prevenirea pierderii clienților prin utilizarea analizei sentimentelor în timp real. Dacă un mesaj primit conține o frustrare intensă sau provine de la un cont corporativ de mare valoare, agentul semnalează imediat conversația. Aceasta ocolește cozile standard și îl direcționează direct pe utilizator către un manager de cont senior.
Un plan pas cu pas pentru implementarea infrastructurii de gestionare a traficului intens
Implementarea agenților autonomi pentru gestionarea vârfurilor de solicitare necesită o planificare clară la nivelul întregii infrastructuri de asistență pentru clienți, al sistemului CRM și al instrumentelor de monitorizare a sistemelor. Urmați acest ghid de implementare pas cu pas pentru a vă pregăti echipa înainte ca un incident să aibă loc.
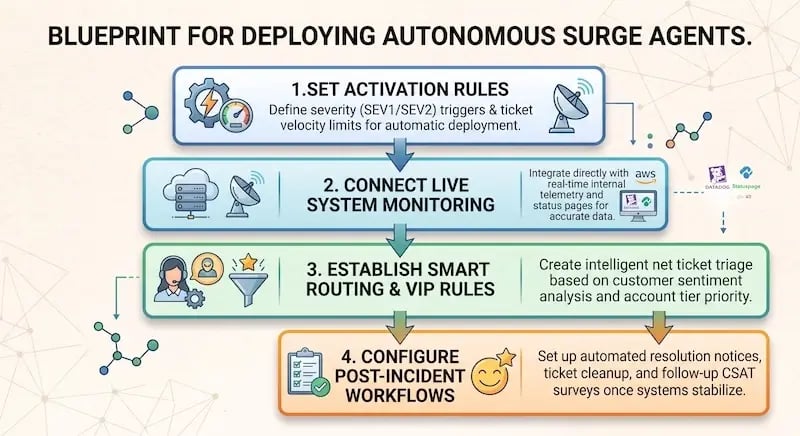
Pasul 1: Setați factorii declanșatori de activare
Definiți indicatorii operaționali exacți care activează agentul în vârfurile de trafic. De exemplu, configurați reguli în motorul de asistență astfel încât dacă viteza de creare a tichetelor crește cu 250% față de valoarea de referință într-un interval de 10 minute, protocolul pentru vârfuri de trafic să fie declanșat automat.
Pasul 2: Conectați instrumentele de telemetrie în timp real și de monitorizare a stării
Un agent autonom pentru vârfuri de trafic este util doar în măsura în care datele pe care se bazează sunt utile. Folosiți API-uri sigure pentru a conecta agentul AI direct la pagina publică de stare și la tablourile de bord interne de monitorizare. Astfel, agentul va comunica întotdeauna detalii verificate, în loc de răspunsuri statice și depășite.
Pasul 3: Stabiliți reguli inteligente de rutare
Nu toate tichetele de asistență ar trebui gestionate integral de IA în timpul unei crize. Creați căi precise de escaladare bazate pe valoarea contului clientului și complexitatea problemei:
-
Nivelul 3 (complexitate redusă): întrebări generale privind starea, probleme de bază legate de încărcarea aplicației și verificări standard ale serviciului.
-
Cale: Rezolvat integral de agentul autonom Surge.
-
-
Nivelul 2 (complexitate medie): întrebări privind facturarea contului, afectate de perioadele de nefuncționare sau de erori în fluxurile de lucru personalizate.
-
Cale: Triate de IA și plasate într-o coadă organizată pentru revizuire umană.
-
-
Nivelul 1 (complexitate ridicată / valoare ridicată): conturi de întreprindere acoperite de SLA, probleme de securitate sau defecțiuni grave critice pentru afaceri.
-
Cale: Redirecționare prioritară imediată către un reprezentant uman dedicat, cu atașarea contextului complet al conversației.
-
Pasul 4: Configurarea curățării post-incident
Când departamentul tehnic marchează un incident ca fiind rezolvat, agentul dvs. de urgență ar trebui să se ocupe automat de comunicările post-incident. Agentul poate:
-
Să trimită notificări automate de restabilire către fiecare utilizator care a contactat serviciul în timpul întreruperii.
-
Să actualizeze starea tichetelor la „Rezolvat” pe toate canalele conectate.
-
Să distribuie chestionare CSAT succinte pentru a colecta feedback cu privire la modul în care a fost gestionată situația.
Această remediere automată economisește echipei de asistență zeci de ore de muncă manuală după un incident, permițându-i să se concentreze imediat pe operațiunile normale.
Construirea unei infrastructuri de asistență reziliente
Întreruperile de sistem și problemele tehnice sunt o parte inevitabilă a operării unei afaceri digitale moderne. Cu toate acestea, nu este necesar să existe o acumulare de solicitări de asistență care să afecteze indicatorii de performanță și să ducă la timpi lungi de așteptare.
Prin implementarea unor agenți autonomi care să facă față afluxului de clienți, organizațiile mari își pot scala instantaneu operațiunile de asistență în timpul unei situații de urgență. Acești agenți inteligenți vă protejează indicatorii cheie de experiență a clientului (CX), reduc cheltuielile operaționale cu asistența și se asigură că clienții dvs. primesc informații clare și precise atunci când au cea mai mare nevoie de ele.
Pentru a construi o infrastructură de servicii pentru clienți rezilientă, bazată pe inteligență artificială, care se adaptează fără probleme la întreruperi și la creșterea rapidă, colaborați cu experții în asistență pentru întreprinderi de la Aspiration Marketing.
De la proiectarea motoarelor inteligente de redirecționare până la integrarea agenților CRM avansați, Aspiration Marketing vă ajută afacerea să ofere experiențe excepționale clienților pe fiecare canal.
Lasă un comentariu
Aveți comentarii despre acest articol?
Împărtășiți-vă opinia, puneți întrebări sau participați la discuție cu comunitatea noastră.