

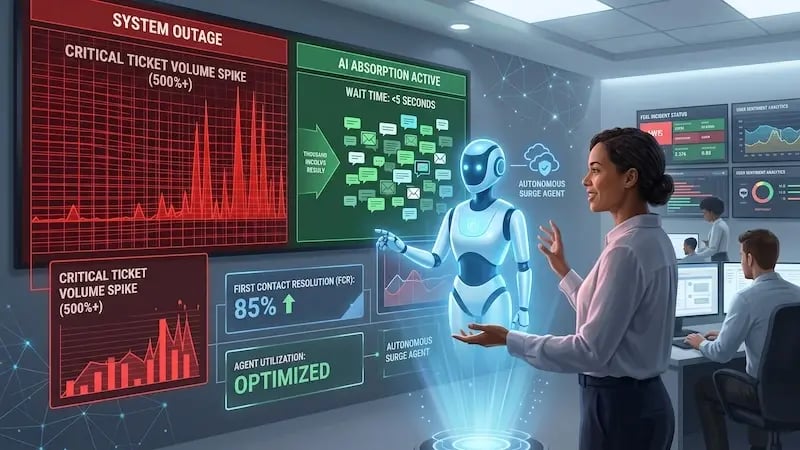
Immaginate questo scenario: sono le 14:15 di un martedì e la vostra piattaforma cloud principale subisce un timeout imprevisto del database. Nel giro di 120 secondi, i ticket di assistenza in arrivo registrano un picco dell’800%. La coda della chat live passa da una normale attesa di 3 minuti a un estenuante ritardo di 4 ore. Le caselle di posta elettronica si riempiono di richieste duplicate e i canali social esplodono di utenti frustrati che pongono esattamente la stessa domanda: “Il sistema è fuori uso?”
 Come reagisce il vostro team di assistenza quando un’improvvisa crisi tecnica travolge le vostre operazioni?
Per la maggior parte delle aziende, un’interruzione di servizio di grandi dimensioni rappresenta un incubo operativo. Gli addetti all’assistenza si ritrovano immediatamente sommersi da migliaia di ticket identici. I tempi di risposta crollano, la soddisfazione dei clienti (CSAT) precipita e il vostro team va in burnout cercando di smaltire manualmente un arretrato che cresce più velocemente di quanto riesca a digitare.
È qui che l’infrastruttura tradizionale del servizio clienti crolla. Le risposte automatiche statiche falliscono perché non forniscono aggiornamenti in tempo reale. Nel frattempo, i team composti esclusivamente da operatori umani semplicemente non riescono ad adattarsi all’istante per assorbire un picco di volume del 1.000% senza causare un enorme sovraccarico.
Per gestire le crisi di sistema senza compromettere le metriche operative, è necessario un sistema di risposta elastico e intelligente. L’implementazione di agenti autonomi per la gestione dei picchi di traffico offre un modo moderno per trasformare la gestione dei picchi di traffico imprevisti, proteggere i flussi di assistenza in tempo reale e mantenere la fiducia durante le interruzioni di servizio ad alto rischio.
Cosa accade durante un picco di incidenti?
Quando un server, un’API o una piattaforma software subisce un’interruzione, l’impatto si propaga rapidamente dal reparto tecnico alle operazioni di assistenza clienti. Mentre gli ingegneri di affidabilità del sito (SRE) si affrettano a individuare la causa principale, i team di assistenza clienti subiscono il peso del panico degli utenti.
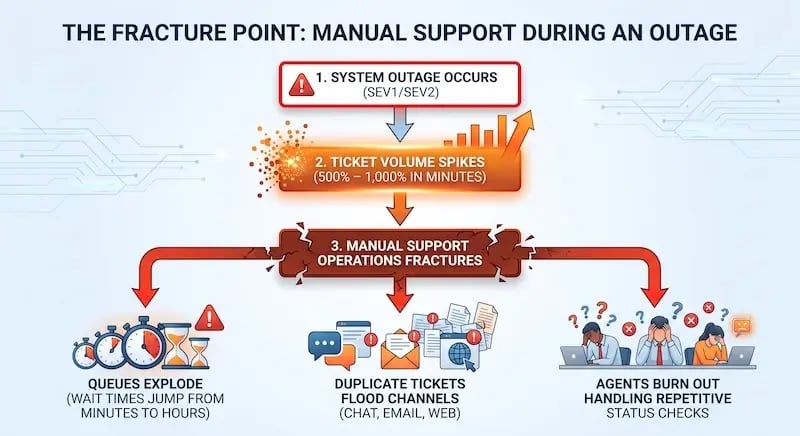
Perché i sistemi di assistenza tradizionali cedono così rapidamente sotto il peso di un incidente? La risposta sta nel modo in cui i flussi di lavoro legacy gestiscono i picchi di traffico.
1. La valanga di ticket duplicati
Quando gli utenti non ricevono una risposta immediata su un canale, raramente aspettano con pazienza.
Infatti, le ricerche dimostrano che
il 56% dei clienti passa immediatamente a un secondo canale di assistenza quando il primo contatto non rispetta i tempi di risposta previsti, mentre il 75% tenta da due a tre contatti separati prima di decidere di aspettare.
Durante un'interruzione imprevista del sistema, questo comportamento fa crescere esponenzialmente il volume dei ticket in arrivo, poiché un singolo cliente che subisce un problema della durata di 10 minuti crea tre o quattro ticket duplicati tra chat, e-mail e social media.
2. Il costo della deviazione statica
Le piattaforme di assistenza tradizionali si affidano a risposte automatiche e statiche o a avvisi generici sotto forma di banner. Sebbene questi strumenti confermino l’esistenza di un problema, raramente forniscono dettagli specifici sull’account né offrono risposte definitive. I clienti considerano i messaggi statici tattiche di deviazione inutili. Di conseguenza, ignorano il banner e inviano comunque un ticket.
3. Il costo finanziario e operativo
I tempi di inattività non pianificati comportano un costo elevato per le organizzazioni moderne.
Le ricerche dimostrano che,
i tempi di inattività IT non pianificati costano alle grandi imprese in media 15.000 dollari al minuto.
Se a ciò si aggiungono le spese operative legate alla gestione del picco di ticket, l’impatto finanziario aumenta in modo significativo.
Gartner riporta che
le interazioni di assistenza in tempo reale costano in media 13,50 dollari ciascuna, contro i soli 1,84 dollari dei canali automatizzati di self-service.
Quando 10.000 utenti contattano l’assistenza durante un’interruzione di due ore, affidarsi alla selezione manuale delle richieste può costare oltre 130.000 dollari solo per le operazioni di assistenza, il tutto per rispondere a domande semplici e ripetitive sullo stato della situazione.

Il problema non è solo finanziario. Quando gli operatori umani dedicano l’80% del loro tempo a rispondere a semplici richieste sullo stato del servizio, i clienti aziendali di alto valore con problemi complessi restano bloccati nella stessa coda. Ciò crea gravi attriti proprio dove la vostra azienda può permetterselo meno.
Cosa sono gli “Autonomous Customer Surge Agents”?
Un agente autonomo per i picchi di richieste dei clienti è un sistema avanzato di intelligenza artificiale progettato per gestire picchi massicci e imprevisti nel volume dell’assistenza clienti. A differenza dei chatbot tradizionali basati su rigidi alberi decisionali, gli agenti autonomi per i picchi utilizzano la comprensione del linguaggio naturale (NLU), integrazioni dinamiche di sistema e trigger di eventi in tempo reale per gestire in modo autonomo le richieste complesse dei clienti.
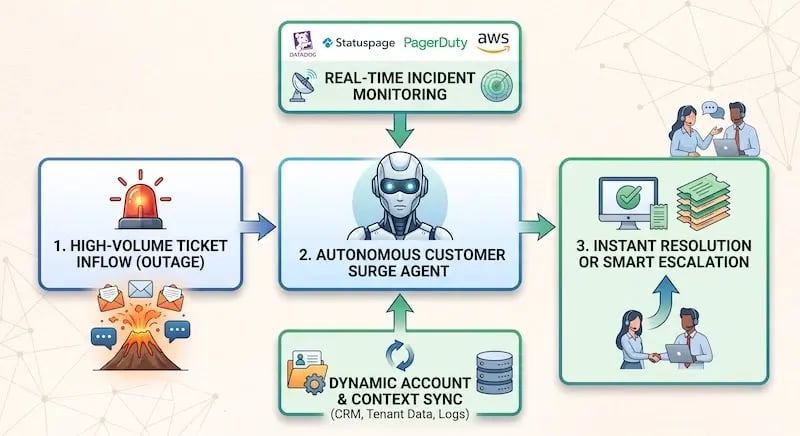 Questi agenti basati sull’intelligenza artificiale operano in modo discreto a fianco del vostro motore di assistenza durante le normali operazioni. Tuttavia, quando la velocità dei ticket supera una soglia specifica — ad esempio un aumento del 300% dei messaggi in entrata nell’arco di cinque minuti — l’agente per i picchi di traffico si attiva automaticamente per assorbire il volume in arrivo.
Funzionalità chiave degli agenti autonomi per i picchi di traffico
| Caratteristica | Chatbot tradizionali | Agenti autonomi di picco |
| Attivazione | Sempre attivi con script fissi | Attivazione elastica basata sulla velocità del traffico in tempo reale |
| Accesso ai dati | Base di conoscenza statica delle FAQ | Connessioni API in tempo reale a strumenti di monitoraggio e di stato del sistema |
| Contesto | Corrispondenza di base delle parole chiave | Contesto a livello di account (ID tenant, livello di tier, stato del sistema) |
| Risoluzione | Reindirizza gli utenti agli articoli | Risolve le richieste dall'inizio alla fine e fornisce aggiornamenti accurati sullo stato |
| Escalation | Passaggio generico agli operatori dal vivo | Instradamento intelligente basato sul sentiment del cliente e sulla priorità VIP |
Come funzionano gli agenti Surge in tempo reale
Consideriamo cosa accade quando un fornitore SaaS subisce un guasto interno alle API:
-
Rilevamento e attivazione: la piattaforma di assistenza rileva un improvviso afflusso di ticket contenenti parole chiave come“errore di connessione” o“pagina 404”. L’agente di picco autonomo si avvia in meno di 5 secondi.
-
Verifica contestuale: l’agente di picco si collega direttamente agli strumenti di monitoraggio interni, come Datadog, Statuspage o PagerDuty. Verifica che esista un incidente SEV1 attivo per la regione del server specifica dell’utente.
-
Personalizzazione a livello di account: quando un utente avvia una chat, l’agente di gestione dei picchi legge il contesto di accesso e l’ID del tenant dell’utente. Anziché fornire una risposta generica, dice: «Ciao, Sarah. Abbiamo riscontrato che il tuo spazio di lavoro principale sul Server East-2 sta attualmente subendo un’interruzione dell’API. Il nostro team di ingegneri sta lavorando a una soluzione e prevediamo che i sistemi torneranno operativi entro 35 minuti."
-
Risoluzione immediata: l’agente chiede all’utente se desidera ricevere una notifica automatica non appena il sistema sarà ripristinato. Una volta che l’utente accetta, l’agente registra la preferenza e chiude il ticket.
Gestendo istantaneamente queste interazioni relative allo stato,
l’agente autonomo di picco è in grado di risolvere fino all’85% dei ticket relativi a interruzioni di servizio senza intervento umano.
In che modo gli agenti autonomi per i picchi di traffico proteggono le metriche fondamentali della CX
Durante una crisi operativa, mantenere la fiducia dei clienti dipende in larga misura dalla rapidità e dalla chiarezza con cui si comunica. Un'interruzione del servizio è frustrante, ma è la comunicazione inadeguata durante l’interruzione a indurre i clienti ad abbandonare definitivamente il servizio.
Un sondaggio tra i consumatori condotto da Xurrent mostra che
il 35% dei consumatori contatta l’assistenza clienti durante un’interruzione del servizio digitale, mentre un altro 34% è costretto a cercare autonomamente aggiornamenti quando i canali di comunicazione non funzionano.
Se questi clienti si imbattono in lunghi tempi di attesa o in risposte poco utili, il tasso di abbandono aumenta rapidamente.
Ecco come gli agenti autonomi per la gestione dei picchi di richieste proteggono le vostre metriche operative e di esperienza chiave durante un incidente.
1. Mantenimento del tempo di prima risposta (FRT)
Durante un picco di traffico significativo, le code standard dell’assistenza in tempo reale si bloccano, aumentando i tempi di prima risposta da 45 secondi a diverse ore. Gli agenti autonomi per i picchi di traffico rispondono in meno di cinque secondi, indipendentemente dal numero di clienti che inviano richieste contemporaneamente, sia 50 sia 50.000. Questa risposta immediata riduce l’ansia degli utenti e impedisce loro di inviare ticket duplicati tramite altri canali.
2. Tutela della risoluzione al primo contatto (FCR)
I benchmark di settore mostrano che,
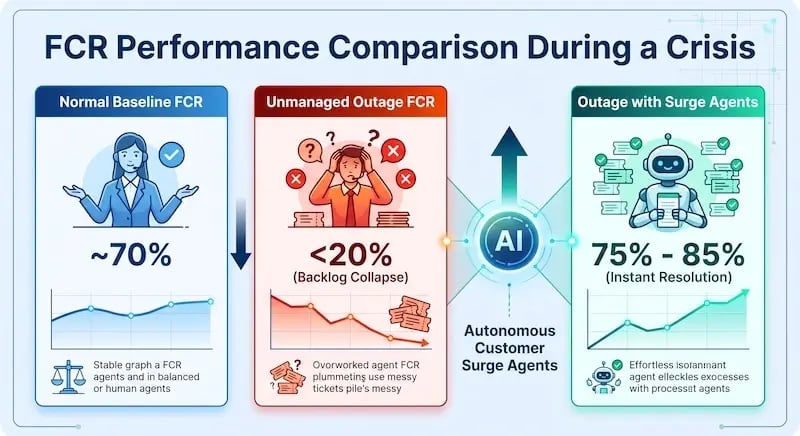
i tassi normali di risoluzione al primo contatto si attestano intorno al 70% per i team più performanti.
Durante un’interruzione non gestita, l’FCR può scendere al di sotto del 20%, poiché gli operatori sono sopraffatti dal carico di lavoro e promettono follow-up che non riescono a monitorare. Gli agenti autonomi di picco mantengono un FCR elevato, fornendo risposte accurate e in tempo reale fin dal primo contatto.
3.Prevenzione dell’abbandono dei clienti nei flussi di assistenza in tempo reale
Quando i sistemi smettono di funzionare, la frustrazione dei clienti aumenta rapidamente.
Le ricerche indicano che
il 33% dei clienti cambierà fornitore dopo una singola interruzione del servizio accompagnata da una comunicazione inadeguata.
Inoltre,
il 32% degli utenti abbandona un marchio dopo due o tre problemi ricorrenti relativi al servizio.
Gli agenti autonomi specializzati nella gestione dei picchi di richieste aiutano a prevenire l’abbandono dei clienti grazie all’analisi del sentiment in tempo reale. Se un messaggio in arrivo esprime una forte frustrazione o proviene da un account aziendale di alto valore, l’agente segnala immediatamente la conversazione. In questo modo, si aggirano le code standard e l’utente viene indirizzato direttamente a un account manager senior.
Una guida passo passo per l’implementazione dell’infrastruttura per i picchi di richieste
L’implementazione di agenti autonomi per la gestione dei picchi di richieste richiede una pianificazione chiara che coinvolga l’infrastruttura di assistenza clienti, il CRM e gli strumenti di monitoraggio del sistema. Seguite questa guida all’implementazione, passo dopo passo, per preparare il vostro team prima che si verifichi un incidente.
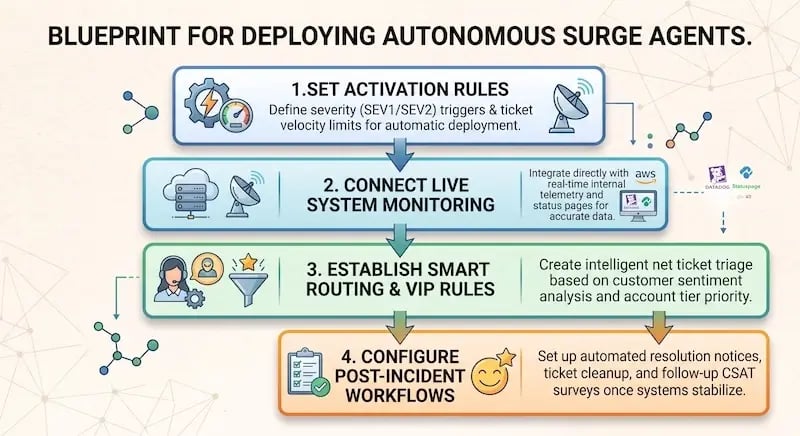
Fase 1: Impostare i trigger di attivazione
Definisci le metriche operative esatte che attivano il tuo agente in caso di picchi di richieste. Ad esempio, configura le regole del tuo motore di assistenza in modo che, se la velocità di creazione dei ticket aumenta del 250% rispetto al valore di riferimento nell'arco di 10 minuti, il protocollo per i picchi di richieste venga attivato automaticamente.
Passo 2: collegare la telemetria in tempo reale e gli strumenti di monitoraggio dello stato
Un agente per i picchi di traffico autonomo è utile solo nella misura in cui lo sono i dati su cui si basa. Utilizza API sicure per collegare il tuo agente AI direttamente alla tua pagina di stato pubblica e alle dashboard di monitoraggio interne. Ciò garantisce che l’agente comunichi sempre dettagli verificati anziché fornire risposte statiche e obsolete.
Fase 3: Definire regole di instradamento intelligenti
Non tutti i ticket di assistenza dovrebbero essere gestiti interamente dall’IA durante una crisi. Crea percorsi di escalation precisi in base al valore dell’account del cliente e alla complessità del problema:
-
Livello 3 (bassa complessità): richieste generali sullo stato, problemi di base relativi al caricamento dell’app e controlli standard del servizio.
-
Percorso: Risolto interamente dall’Autonomous Surge Agent.
-
-
Livello 2 (complessità media): domande sulla fatturazione dell’account legate a tempi di inattività o errori nei flussi di lavoro personalizzati.
-
Percorso: smistate dall’IA e inserite in una coda organizzata per la revisione da parte di un operatore umano.
-
-
Livello 1 (Alta complessità / Alto valore): account aziendali coperti da SLA, problemi di sicurezza o gravi malfunzionamenti critici per l’attività.
-
Percorso: Inoltro immediato con priorità a un operatore umano dedicato, con allegato il contesto completo della conversazione.
-
Fase 4: Configurazione della gestione post-incidente
Quando il team tecnico contrassegna un incidente come risolto, il vostro agente di picco dovrebbe gestire automaticamente le comunicazioni post-incidente. L'agente può:
-
Inviare notifiche automatiche di ripristino a tutti gli utenti che hanno contattato l’assistenza durante l’interruzione del servizio.
-
Aggiornare lo stato dei ticket a "Risolto" su tutti i canali collegati.
-
Distribuire brevi sondaggi CSAT per raccogliere feedback su come è stata gestita la situazione.
Questa gestione automatizzata fa risparmiare al team di assistenza decine di ore di lavoro manuale dopo un incidente, consentendo loro di concentrarsi immediatamente sulle attività ordinarie.
Costruire un'infrastruttura di assistenza resiliente
Le interruzioni di sistema e i disservizi tecnici sono una parte inevitabile della gestione di un'azienda digitale moderna. Tuttavia, non è detto che si debbano verificare arretrati di assistenza che compromettono le metriche e comportano lunghi tempi di attesa.
Implementando agenti autonomi in grado di gestire i picchi di richieste dei clienti, le organizzazioni aziendali possono scalare istantaneamente le proprie operazioni di assistenza in caso di emergenza. Questi agenti intelligenti proteggono le metriche fondamentali dell’esperienza del cliente (CX), riducono i costi operativi di assistenza e garantiscono che i clienti ricevano informazioni chiare e accurate proprio quando ne hanno più bisogno.
Per creare un’infrastruttura di assistenza clienti resiliente e basata sull’intelligenza artificiale, in grado di adattarsi senza intoppi alle interruzioni di servizio e alla rapida crescita, affidatevi agli esperti di assistenza clienti di Aspiration Marketing.
Dalla progettazione di motori di instradamento intelligenti all’integrazione di agenti CRM avanzati, Aspiration Marketing aiuta la vostra azienda a offrire esperienze cliente eccezionali su ogni canale.
Lascia un commento
Hai considerazioni su questo articolo?
Condividi il tuo feedback, fai domande o partecipa alla discussione con la nostra community.