

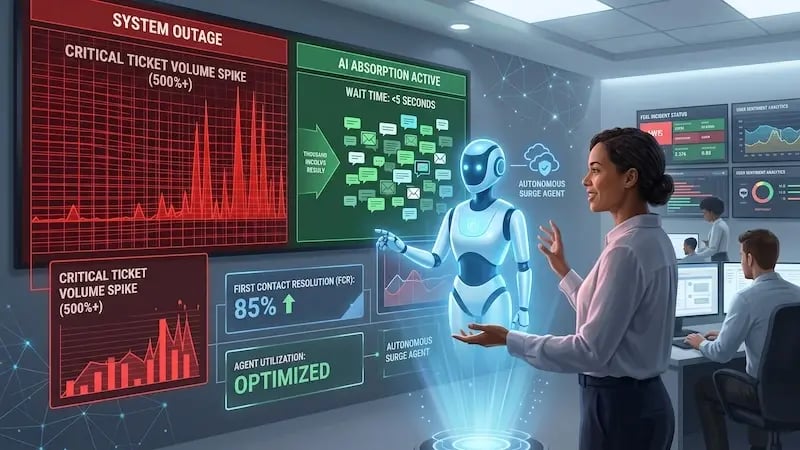
Imaginez le scénario suivant : il est 14 h 15, un mardi, et votre plateforme cloud principale subit un délai d'attente inattendu sur la base de données. En l'espace de 120 secondes, le nombre de tickets d'assistance reçus explose de 800 %. La file d'attente de votre chat en direct passe d'un temps d'attente habituel de 3 minutes à un retard cumulé de 4 heures. Les boîtes de réception se remplissent de demandes en double, et les réseaux sociaux sont submergés d'utilisateurs frustrés posant tous exactement la même question : « Le système est-il en panne ? »
 Comment votre équipe d’assistance réagit-elle lorsqu’une crise technique soudaine submerge vos opérations ?
Pour la plupart des entreprises, une panne majeure est un véritable cauchemar opérationnel. Les agents du support se retrouvent instantanément submergés par des milliers de tickets identiques. Les délais de réponse s’effondrent, la satisfaction client (CSAT) s’effondre, et votre équipe s’épuise à essayer de résorber manuellement un retard qui s’accumule plus vite qu’elle ne peut taper.
C’est là que l’infrastructure traditionnelle du service client s’effondre. Les réponses automatiques statiques échouent car elles ne fournissent pas de mises à jour en temps réel. De leur côté, les équipes composées uniquement d’humains ne peuvent tout simplement pas s’adapter instantanément pour absorber une hausse de volume de 1 000 % sans générer des coûts supplémentaires considérables.
Pour gérer les crises du système sans compromettre vos indicateurs opérationnels, vous avez besoin d’un système de réponse à la fois élastique et intelligent. Le déploiement d’agents autonomes spécialisés dans la gestion des pics de demande offre une solution moderne pour transformer la manière dont les grandes entreprises gèrent les pics de trafic inattendus, protègent les flux d’assistance en direct et préservent la confiance lors de pannes à fort enjeu.
Que se passe-t-il lors d’un pic d’incidents ?
Lorsqu’un serveur, une API ou une plateforme logicielle subit une interruption de service, l’impact se répercute rapidement de l’ingénierie aux opérations client. Tandis que les ingénieurs en fiabilité des sites (SRE) s’empressent de résoudre la cause première, les équipes d’assistance client subissent de plein fouet la panique des utilisateurs.
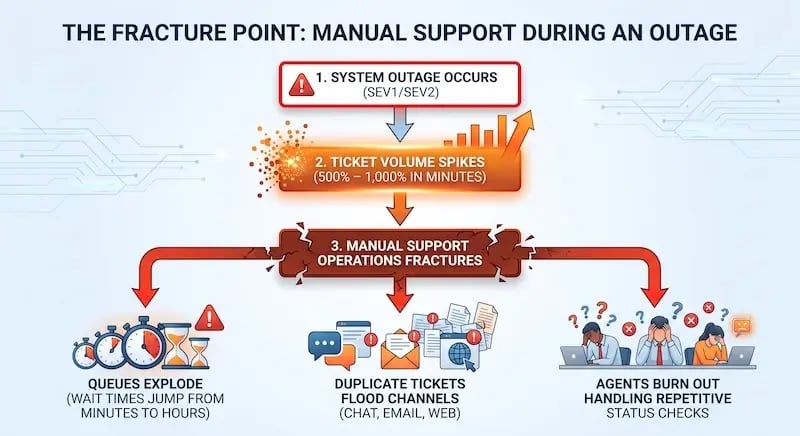
Pourquoi les systèmes d’assistance traditionnels s’effondrent-ils si rapidement sous le poids d’un incident ? La réponse réside dans la manière dont les workflows hérités gèrent les pics de trafic.
1. L’avalanche de tickets en double
Lorsque les utilisateurs ne reçoivent pas de réponse immédiate sur un canal, ils ne patientent rarement.
En effet, des études montrent que
56 % des clients se tournent immédiatement vers un deuxième canal d’assistance lorsque leur premier contact ne respecte pas le délai de réponse, et 75 % d’entre eux tentent deux à trois contacts distincts avant de se résigner à attendre.
Lors d’une panne imprévue du système, ce comportement entraîne une croissance exponentielle du volume de tickets entrants, car un seul client confronté à un problème pendant 10 minutes génère trois ou quatre tickets en double via le chat, l’e-mail et les réseaux sociaux.
2. Le coût de la déviation statique
Les plateformes d’assistance traditionnelles s’appuient sur des réponses automatiques statiques ou sur des alertes sous forme de bannières génériques. Si ces outils confirment l’existence d’un problème, ils fournissent rarement des détails spécifiques au compte ou des réponses définitives. Les clients perçoivent ces messages statiques comme des tactiques de déviation inutiles. En conséquence, ils ignorent la bannière et soumettent quand même un ticket.
3. Le coût financier et opérationnel
Les temps d’arrêt imprévus entraînent des coûts financiers élevés pour les entreprises modernes.
Des études montrent que,
les temps d’arrêt informatiques imprévus coûtent en moyenne 15 000 dollars par minute aux grandes entreprises.
Si l’on ajoute à cela les coûts opérationnels liés au traitement d’un afflux de tickets, l’impact financier augmente considérablement.
Gartner indique que
les interactions d’assistance en direct coûtent en moyenne 13,50 dollars par interaction, contre seulement 1,84 dollar pour les canaux de libre-service automatisés.
Lorsque 10 000 utilisateurs contactent le service d’assistance pendant une panne de deux heures, le triage manuel peut coûter plus de 130 000 dollars rien qu’aux opérations d’assistance, et ce, uniquement pour répondre à des questions simples et répétitives sur l’état d’avancement.

Le problème n’est pas uniquement financier. Lorsque les agents humains consacrent 80 % de leur temps à répondre à de simples demandes de statut, les clients professionnels à forte valeur ajoutée, confrontés à des problèmes complexes, se retrouvent coincés dans exactement la même file d’attente. Cela crée de graves frictions là où votre entreprise peut le moins se le permettre.
Quels sont les agents autonomes de gestion des pics de demande ?
Un agent autonome de gestion des pics de demande est un système d’IA avancé conçu pour gérer les pics massifs et inattendus du volume de demandes d’assistance. Contrairement aux chatbots traditionnels qui s’appuient sur des arbres de décision rigides, ces agents autonomes utilisent la compréhension du langage naturel (NLU), des intégrations système dynamiques et des déclencheurs d’événements en temps réel pour traiter de manière autonome les demandes complexes des clients.
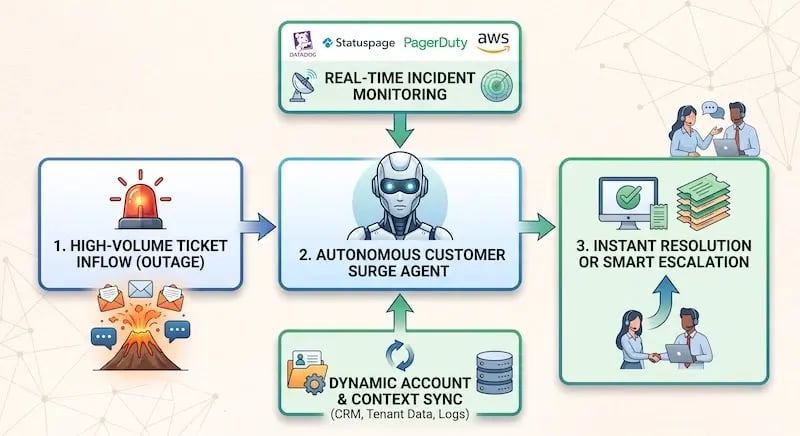 Ces agents d’IA restent en veille à côté de votre moteur d’assistance pendant les opérations normales. Cependant, lorsque le flux de tickets dépasse un seuil spécifique — par exemple une augmentation de 300 % des messages entrants en cinq minutes —, l’agent de gestion des pics d’activité s’active automatiquement pour absorber le volume entrant.
Principales fonctionnalités des agents autonomes de gestion des pics de demande
| Fonctionnalité | Chatbots traditionnels | Agents autonomes de gestion des pics |
| Activation | Toujours actifs avec des scripts fixes | Activation flexible en fonction du débit du trafic en temps réel |
| Accès aux données | Base de connaissances statique sous forme de FAQ | Connexions API en direct aux outils de surveillance et de suivi de l'état du système |
| Contexte | Correspondance de mots-clés de base | Contexte au niveau du compte (identifiant du locataire, niveau de service, état du système) |
| Résolution | Redirige les utilisateurs vers des articles | Traite les demandes de bout en bout et fournit des mises à jour précises sur l'état d'avancement |
| Transfert | Transfert générique vers des agents en direct | Routage intelligent basé sur le sentiment du client et la priorité VIP |
Fonctionnement des agents de renfort en temps réel
Imaginons ce qui se passe lorsqu’un fournisseur SaaS rencontre une défaillance interne de son API :
-
Détection et déclenchement : la plateforme d’assistance détecte un afflux soudain de tickets contenant des mots-clés tels que «erreur de connexion » ou «page 404 ». L’agent de renfort autonome se met en place en moins de cinq secondes.
-
Vérification contextuelle : l’agent de renfort se connecte directement aux outils de surveillance internes tels que Datadog, Statuspage ou PagerDuty. Il vérifie qu’un incident SEV1 actif existe bien pour la région du serveur spécifique à l’utilisateur.
-
Personnalisation au niveau du compte : lorsqu’un utilisateur ouvre une conversation par chat, l’agent de gestion des pics de trafic lit le contexte de connexion de l’utilisateur ainsi que son identifiant de locataire. Au lieu de donner une réponse générique, il dit : « Bonjour, Sarah. Nous constatons que votre espace de travail principal sur le serveur East-2 est actuellement affecté par une panne de l’API. Notre équipe d'ingénieurs travaille à résoudre le problème et nous prévoyons le rétablissement des systèmes d'ici 35 minutes. »
-
Résolution instantanée : l’agent demande à l’utilisateur s’il souhaite recevoir une notification automatique dès que le système sera rétabli. Une fois que l’utilisateur a accepté, l’agent enregistre cette préférence et clôt le ticket.
En traitant instantanément ces interactions liées à l’état du système,
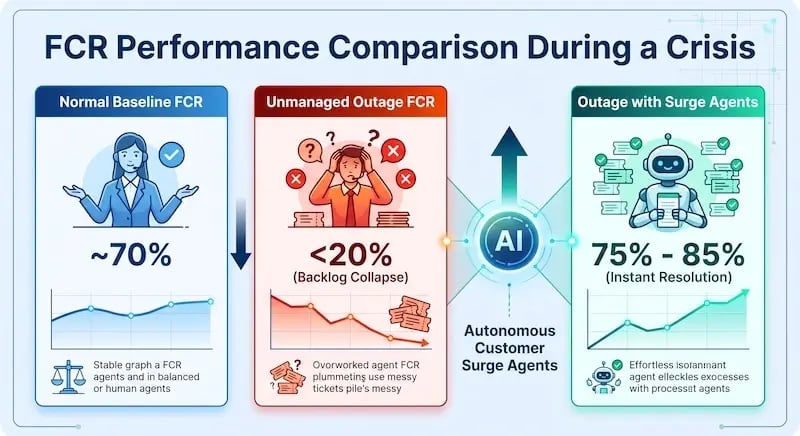
l’agent autonome de renfort peut résoudre jusqu’à 85 % des tickets liés à des pannes sans intervention humaine.
Comment les agents autonomes de gestion des pics de trafic protègent les indicateurs clés de l’expérience client
Lors d’une crise opérationnelle, le maintien de la confiance des clients dépend fortement de la rapidité et de la clarté de votre communication. Une panne de service est frustrante, mais c’est une mauvaise communication pendant cette panne qui pousse les clients à partir définitivement.
Une enquête menée auprès des consommateurs par Xurrent montre que
35 % des consommateurs contactent le service client lors d’une panne numérique, tandis que 34 % sont contraints de rechercher eux-mêmes des informations lorsque les canaux de communication sont indisponibles.
Si ces clients sont confrontés à de longs délais d’attente ou à des réponses peu utiles, le taux de désabonnement augmente rapidement.
Voici comment les agents autonomes de gestion des pics de demande protègent vos indicateurs clés d’exploitation et d’expérience client en cas d’incident.
1. Préserver le temps de première réponse (FRT)
Lors d’un pic de demande important, les files d’attente standard de l’assistance en direct sont saturées, ce qui fait passer le temps de première réponse de 45 secondes à plusieurs heures. Les agents autonomes dédiés aux pics de demande répondent en moins de cinq secondes, que 50 ou 50 000 clients envoient une demande simultanément. Cette réponse immédiate réduit l’anxiété des utilisateurs et les empêche de soumettre des tickets en double via d’autres canaux.
2. Protéger le taux de résolution dès le premier contact (FCR)
Les références du secteur montrent que,
les taux normaux de résolution dès le premier contact avoisinent les 70 % pour les équipes très performantes.
Lors d’une panne non gérée, le FCR peut chuter en deçà de 20 %, car les agents sont débordés et promettent des suivis qu’ils ne peuvent pas assurer. Les agents autonomes de renfort maintiennent un FCR élevé en fournissant des réponses précises et en temps réel dès le tout premier contact.
3.Prévenir la perte de clientèle dans les flux d’assistance en direct
Lorsque les systèmes tombent en panne, la frustration des clients augmente rapidement.
Des études indiquent que
33 % des clients changent de prestataire après une seule panne de service accompagnée d’une mauvaise communication.
De plus,
32 % des utilisateurs quittent une marque après deux ou trois problèmes de service récurrents.
Les agents autonomes chargés de gérer les pics de demande contribuent à prévenir la perte de clientèle grâce à une analyse des sentiments en temps réel. Si un message entrant exprime une frustration intense ou provient d’un compte d’entreprise à forte valeur ajoutée, l’agent signale immédiatement la conversation. Celle-ci contourne les files d’attente standard et est transmise directement à un chargé de compte senior.
Un plan d’action étape par étape pour la mise en œuvre d’une infrastructure de gestion des pics de demande
Le déploiement d’agents autonomes de gestion des pics de demande nécessite une planification claire de votre infrastructure de service client, de votre CRM et de vos outils de surveillance des systèmes. Suivez ce guide de mise en œuvre, étape par étape, pour préparer votre équipe avant qu’un incident ne survienne.
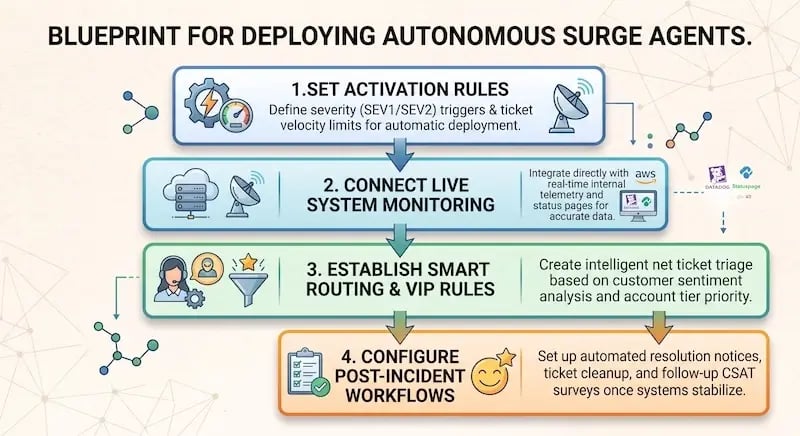
Étape 1 : Définir les déclencheurs d’activation
Définissez les indicateurs opérationnels précis qui déclenchent l’activation de votre agent de gestion des pics de demande. Par exemple, configurez des règles dans votre moteur d’assistance de sorte que si le rythme de création de tickets augmente de 250 % par rapport à la valeur de référence au cours d’une fenêtre de 10 minutes, le protocole de gestion des pics de demande soit automatiquement déclenché.
Étape 2 : Connectez les outils de télémétrie en temps réel et de suivi de l’état
L’utilité d’un agent de gestion des pics de trafic autonome dépend entièrement de la qualité des données sur lesquelles il s’appuie. Utilisez des API sécurisées pour connecter directement votre agent d’IA à votre page d’état publique et à vos tableaux de bord de surveillance internes. Cela garantit que l’agent communique toujours des informations vérifiées plutôt que des réponses statiques et obsolètes.
Étape 3 : Définir des règles de routage intelligentes
Tous les tickets d’assistance ne doivent pas nécessairement être entièrement traités par l’IA en cas de crise. Créez des parcours d’escalade précis en fonction de la valeur du compte client et de la complexité du problème :
-
Niveau 3 (faible complexité) : demandes générales d'informations sur l'état du service, problèmes élémentaires de chargement de l'application et vérifications standard du service.
-
Parcours : Traité intégralement par l’Autonomous Surge Agent.
-
-
Niveau 2 (complexité moyenne) : questions relatives à la facturation des comptes affectés par des interruptions de service ou par des erreurs de workflow personnalisées.
-
Parcours : triées par l’IA et placées dans une file d’attente, en vue d’un examen par un humain.
-
-
Niveau 1 (haute complexité / haute valeur) : comptes d'entreprise couverts par un SLA, problèmes de sécurité ou pannes critiques graves pour l'activité.
-
Parcours : acheminement prioritaire immédiat vers un interlocuteur humain dédié, avec le contexte complet de la conversation joint.
-
Étape 4 : Configurer le nettoyage post-incident
Lorsque l'équipe technique marque un incident comme résolu, votre agent de renfort doit automatiquement prendre en charge les communications post-incident. L'agent peut :
-
Envoyer des notifications automatiques de rétablissement à tous les utilisateurs ayant contacté le service pendant la panne.
-
Mettre à jour le statut des tickets en «Résolu » sur tous les canaux concernés.
-
Diffuser de brèves enquêtes de satisfaction client (CSAT) afin de recueillir des retours sur la manière dont la situation a été gérée.
Ce nettoyage automatisé permet à votre équipe d’assistance d’économiser des dizaines d’heures de travail manuel après un incident, ce qui lui permet de se concentrer immédiatement sur les opérations courantes.
Mettre en place une infrastructure d’assistance résiliente
Les pannes de système et les perturbations techniques font inévitablement partie de l’exploitation d’une entreprise numérique moderne. Cependant, les retards dans le traitement des demandes d’assistance et les longs délais d’attente, qui nuisent aux indicateurs de performance, ne sont pas une fatalité.
En déployant des agents autonomes capables de faire face à un pic de demandes clients, les grandes entreprises peuvent faire évoluer instantanément leurs opérations d’assistance en cas d’urgence. Ces agents intelligents protègent vos indicateurs clés d’expérience client, réduisent les coûts opérationnels liés à l’assistance et garantissent que vos clients reçoivent des informations claires et précises lorsqu’ils en ont le plus besoin.
Pour mettre en place une infrastructure de service client résiliente, alimentée par l’IA, capable de s’adapter en douceur aux pannes et à une croissance rapide, faites appel aux experts en assistance d’entreprise d’Aspiration Marketing.
De la conception de moteurs de routage intelligents à l’intégration d’agents CRM avancés, Aspiration Marketing aide votre entreprise à offrir des expériences client exceptionnelles sur tous les canaux.
Laisser un commentaire
Une réaction à cet article ?
Partagez votre avis, posez des questions ou rejoignez la discussion avec notre communauté.