

Perché i dashboard dei fornitori mostrano un tasso di risoluzione del 75%, mentre i punteggi di soddisfazione dei clienti sono in calo? Perché i vostri team di assistenza umana sono ancora sommersi da ticket complessi riaperti?
La spiegazione è piuttosto semplice. I tuoi addetti al servizio clienti non stanno facendo un buon lavoro. Per niente.
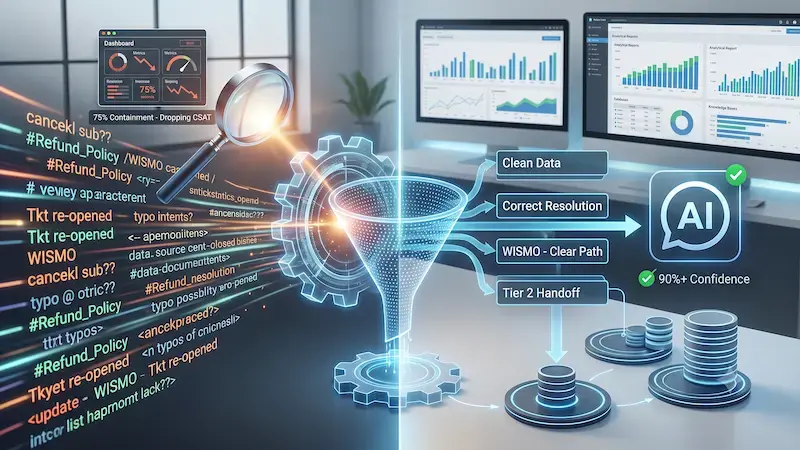 C'è un'enorme e costosa differenza tra "contenimento" e "vera risoluzione". Il contenimento significa semplicemente che uno strumento automatizzato ha impedito a un utente di contattare un operatore umano. Non significa che il sistema abbia effettivamente risolto il problema del cliente.
Questo problema è molto diffuso nelle moderne strutture di assistenza.
I dati di mercato forniti da Calabrio rivelano che fino al 98% dei contact center utilizza ormai una qualche forma di intelligenza artificiale all’interno dei propri flussi di lavoro.
Tuttavia,
solo il 12% di queste organizzazioni dispone di una strategia dei dati completamente ottimizzata a supporto di tale implementazione.
Inoltre,
i rapporti di Gartner indicano che, sebbene il 91% dei responsabili dell’assistenza clienti subisca forti pressioni da parte dei dirigenti per implementare strumenti automatizzati, molti faticano a comunicare con sicurezza al consiglio di amministrazione l’effettiva precisione delle risoluzioni ottenute tramite l’IA.
Infatti,
quasi il 71% dei responsabili del servizio clienti ammette di non poter verificare con sicurezza i propri reali tassi di risoluzione autonoma davanti al consiglio di amministrazione.
Questa mancanza di trasparenza si verifica perché le verifiche manuali spesso rivelano che le metriche automatizzate appaiono due volte migliori della realtà quando non si tiene traccia dei contatti ripetuti o delle escalation nascoste.
Non è possibile correggere i sistemi di assistenza automatizzata se i dati relativi all’assistenza clienti sono inaffidabili. Quando si addestra o si configura un sistema di IA sulla base di registri storici dei ticket disordinati e non verificati, le prestazioni calano immediatamente. Il sistema eredita gli errori presenti nei dati precedenti. Per sbloccare la vera efficienza, è necessario andare oltre le semplici statistiche di deviazione. Questa guida approfondita fornisce un quadro rigoroso per la verifica delle trascrizioni delle conversazioni, l’isolamento degli errori nascosti nei casi limite e la pulizia dei dati di assistenza sottostanti.
Che cos’è l’accuratezza di risoluzione dell’IA?
Per correggere la vostra piattaforma automatizzata, dovete stabilire con precisione cosa state misurando. L’accuratezza di risoluzione dell’IA è la percentuale di interazioni totali con i clienti che un agente IA risolve completamente al primo tentativo, senza intervento umano, allucinazioni o necessità che l’utente ricontatti il vostro team.
Si tratta di un concetto distinto dal tasso di risoluzione automatizzata (ARR) o dal tasso di deviazione visibile nelle dashboard dei software standard. Considerate questa formula: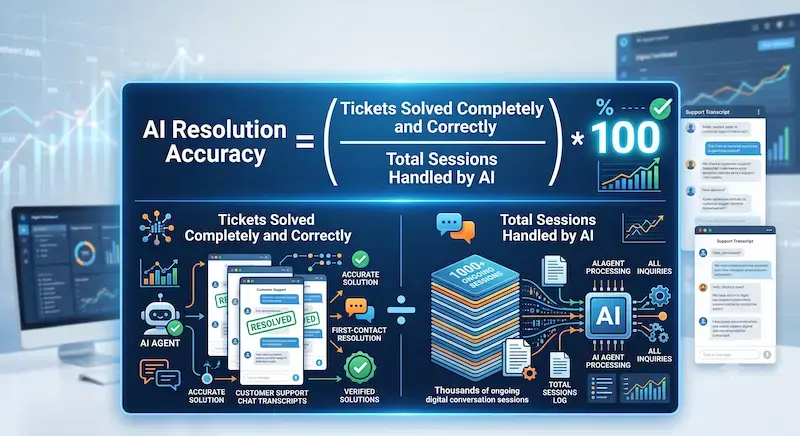 Le piattaforme software standard spesso registrano una deviazione riuscita ogni volta che un cliente chiude un widget di chat. Ma quel cliente ha effettivamente ottenuto la risposta che cercava? Oppure ha chiuso la finestra per pura frustrazione? La vera precisione di risoluzione richiede la convalida dei dati reali. Essa conferma che l’intento del cliente sia stato soddisfatto in modo accurato, sicuro e nel pieno rispetto delle attuali politiche aziendali.
Perché i dati di assistenza “sporchi” distorcono le prestazioni dell’IA
I dati dell’assistenza clienti sono caotici per natura. I ticket reali dei clienti sono pieni di errori di battitura, formattazioni complesse, testi di avviso generati dal sistema e di rumore conversazionale. Spesso i clienti raggruppano tre richieste completamente estranee tra loro in un unico thread di testo.
Quando i log di testo grezzi e non puliti vengono inseriti in un Large Language Model (LLM) o in una knowledge base di tipo Retrieval-Augmented Generation (RAG), le prestazioni ne risentono. L’automazione assorbe risposte obsolete, link web non funzionanti e abitudini di instradamento umano inadeguate.
È semplice:
Log di assistenza non puliti ➔ Pipeline di conoscenza RAG ➔ Allucinazioni dell’IA e risoluzioni errate
Il rischio aziendale, in questo caso, è misurabile.
Un rapporto di settore di RevSure rivela che il 49% dei dirigenti cita le imprecisioni nei dati e i pregiudizi strutturali come i principali ostacoli al successo nella scalabilità dell’IA agentica.
La scarsa qualità dei dati costringe inoltre le aziende ad abbandonare completamente le funzionalità avanzate.
Una ricerca di Gartner indica che, entro il 2026, le organizzazioni abbandoneranno fino al 60% dei progetti di IA a causa della mancanza di dati “pronti per l’IA”.
Se i dati di base del supporto sono strutturalmente difettosi, anche la logica automatizzata risulterà compromessa.
Il modello in 4 fasi per verificare e ripulire i dati dell’assistenza clienti
È possibile eliminare sistematicamente questi problemi di prestazioni. Utilizzate questo quadro in quattro fasi per verificare le vostre trascrizioni attuali, eliminare i dati errati e proteggere la vostra esperienza automatizzata del cliente. In questo modo, i vostri agenti orientati agli obiettivi potranno effettivamente raggiungerli.

Fase 1: Stabilite la vostra “Ground Truth” tramite la revisione manuale delle trascrizioni
Non è possibile correggere un sistema automatizzato senza una chiara base di riferimento su come dovrebbe essere una risposta perfetta. È necessario creare un set di dati di “realtà di riferimento”. Si tratta di una raccolta curata di richieste dei clienti verificate, ciascuna abbinata alla sua risoluzione esatta e ideale.
Iniziate estraendo un campione casuale di 500 interazioni autonome recenti con i clienti. Non limitatevi a verificare se lo stato del ticket è contrassegnato come chiuso. Leggete direttamente il testo della conversazione. Cercate attentamente queste tre modalità di fallimento nascoste:
-
Abbandono silenzioso: il cliente ha smesso di rispondere del tutto perché le risposte automatiche risultavano confuse, circolari o ripetitive. Se n’è andato senza una soluzione.
-
Il "ciclo delle politiche": il sistema ha esposto correttamente una politica aziendale generica, ma non è riuscito ad affrontare l’eccezione specifica e concreta richiesta dall’utente. Ciò lascia irrisolto il problema principale.
-
Il ricontatto entro 24 ore: il sistema ha chiuso la sessione di chat in modo corretto, ma il cliente ha aperto un ticket identico via e-mail o telefono entro 24 ore perché la risposta iniziale non ha funzionato.
Documentare questi fallimenti ti aiuta a individuare i punti in cui la comprensione del tuo sistema si blocca in scenari reali. Quando individui queste tendenze, puoi vedere chiaramente il divario tra ciò che la tua dashboard definisce una “deviazione” e ciò che il tuo cliente definisce un “fallimento”.
Fase 2: Pulire e eliminare il rumore dai dati storici dell’assistenza
Una volta compresi gli errori più comuni del sistema, è necessario ripulire il database. Questo processo agisce come una lavatrice per i dati dell’assistenza clienti prima che vengano immessi nel motore di automazione in tempo reale. Consideratelo un’operazione di eliminazione del rumore, affinché il modello possa cogliere il segnale.
|
Problema relativo ai dati |
Presentazione visiva nei log |
Azione di pulizia tecnica |
|---|---|---|
|
Intento confuso |
I tag sovrapposti, come #Refund_Policy e #Return_Instructions, confondono il modello. |
Unire le categorie identiche in un'unica mappa degli intenti, in modo che si escludano a vicenda. |
|
Contesto obsoleto |
Vecchie strutture dei prezzi, link a piattaforme non più attive o documentazione sui prodotti scaduta. |
Eliminare completamente i file obsoleti dalle directory di conoscenza del RAG. |
|
Rumore testuale di sistema |
Messaggi interni di automazione del CRM, come "Ticket spostato nella coda di livello 2", presenti nelle trascrizioni degli utenti. |
Esegui filtri automatici tramite script per rimuovere i metadati interni del sistema. |
La pulizia di questi record garantisce che il sistema si basi esclusivamente su informazioni accurate e aggiornate. Ciò riduce al minimo il rischio di fornire risposte contraddittorie ai clienti.
Infatti, le valutazioni tecniche di Atlan dimostrano che,
basare i propri modelli su un framework RAG altamente pulito e ben mantenuto può ridurre i tassi di “allucinazione” fino all’85% rispetto ai sistemi non basati su un framework di questo tipo.
Fase 3: Isolare e classificare le imprecisioni nei casi limite
Le semplici richieste dei clienti sono facili da automatizzare.
Le richieste standard come "Dov'è il mio ordine?" (WISMO) costituiscono in genere dal 35% al 40% di tutto il volume dell'assistenza nel settore della vendita al dettaglio online, secondo WISMO.
I sistemi automatizzati gestiscono queste attività di base senza difficoltà perché si collegano direttamente a flussi di dati API prevedibili. La vera prova dell’accuratezza della risoluzione della vostra IA risiede nel restante 60% di scenari complessi e di nicchia dei clienti.
Quando individuate un errore di automazione durante la verifica dei dati, classificatelo in una di queste tre specifiche categorie operative:
-
Disallineamento contestuale: l’agente automatizzato ha trascurato un dettaglio fondamentale nel messaggio dell’utente, ad esempio confondendo una richiesta di cancellazione con una di sospensione temporanea.
-
Lacune di conoscenza: le informazioni precise necessarie per risolvere il problema dell’utente non sono mai state documentate negli articoli ufficiali della vostra knowledge base. L’IA è stata costretta a tirare a indovinare.
-
Errori di protezione: il sistema ha adottato uno stile di conversazione inappropriato, ha diffuso voci non verificate sugli aggiornamenti del prodotto o ha fornito consigli transazionali non autorizzati.
Classificare gli errori aiuta a individuare con precisione le correzioni tecniche necessarie. Anziché cercare di indovinare il motivo del malfunzionamento del sistema, è possibile individuare esattamente quale modulo, prompt o articolo abbia causato il guasto. Ciò consente al team di sviluppo di risparmiare ore di ricerca del problema senza un obiettivo preciso.
Fase 4: Implementare controlli di triage basati sull’affidabilità
Non è necessario costringere la piattaforma automatizzata a risolvere ogni singolo ticket. Farlo è la ricetta per la frustrazione dei clienti. Utilizzate invece i punteggi di affidabilità in tempo reale per costruire un quadro di triage dinamico. I motori conversazionali più avanzati calcolano un punteggio di probabilità interno per ogni risposta generata, basato sulla corrispondenza tra la richiesta dell’utente e i dati disponibili.
-
Calcolo dell’affidabilità della risposta: il sistema valuta il testo inviato dal cliente, confrontandolo con i dati di conoscenza disponibili, e assegna un punteggio percentuale di precisione.
-
Eseguire l’automazione ad alta affidabilità: se il punteggio calcolato è ben al di sopra del 90%, il sistema invia immediatamente la risposta e risolve il problema senza l’intervento umano.
-
Inoltro delle bozze a media affidabilità: se il punteggio rientra tra il 70% e il 90%, il sistema redige una bozza di risposta e la inoltra a un membro del team umano per la revisione, la modifica e l’approvazione prima che il cliente la veda.
-
Attivare il trasferimento in caso di bassa affidabilità: se il punteggio scende al di sotto del 70%, il sistema bypassa completamente l’automazione e trasferisce il cliente a un operatore umano in tempo reale, in modo trasparente e con il contesto completo.
Questo approccio di triage garantisce il mantenimento di un elevato livello di qualità. Mantenendo un operatore umano coinvolto nelle richieste ambigue, si evita che l’IA commetta errori evidenti in pubblico.
Trasformare gli approfondimenti dell’audit in linee guida per i prompt
Una volta identificate le principali lacune nei dati, non è necessario addestrare nuovamente i modelli di base da zero. Il riaddestramento è costoso e richiede molto tempo. È invece sufficiente adeguare i limiti dei prompt e le istruzioni di sistema che regolano il comportamento quotidiano dell’agente in tempo reale.
Implementate rigidi vincoli negativi nei prompt del sistema. Indica al sistema esattamente cosa non deve né fare né dire. Questi limiti impediscono al modello di concedersi libertà creative rispetto alle vostre politiche aziendali. Ad esempio, potete inserire una direttiva operativa precisa come questa nei parametri di base del sistema:
"Se un cliente chiede di modificare un piano di abbonamento aziendale, non devi mai citare le fasce di prezzo standard al dettaglio. Trasferisci immediatamente l’interazione al team di gestione degli account."
Inoltre, concentrate i vostri sforzi di ottimizzazione direttamente sulla documentazione di riferimento. Se un agente automatizzato fornisce una risposta errata riguardo alla procedura di garanzia, la causa principale è quasi sempre un articolo del centro assistenza ambiguo, confuso o obsoleto. Gli agenti basati sull’IA non inventano nulla; amplificano le contraddizioni già presenti nei vostri file. Quando ripulite il testo della documentazione di origine, l’accuratezza delle risoluzioni fornite in tempo reale dall’IA migliora automaticamente.
Garanzia di qualità continua per un successo a lungo termine
La pulizia dei dati non è mai un progetto una tantum. È un’abitudine operativa continua. I vostri cataloghi di prodotti interni si aggiornano, i vostri strumenti software aziendali si evolvono e i comportamenti reali dei clienti cambiano nel tempo. Se trattate l’igiene dei dati come una singola tappa, la precisione della vostra automazione si ridurrà entro tre-sei mesi.
Stabilite un ritmo strutturato e continuo di controllo qualità. Chiedete ai vostri responsabili della qualità del supporto di dedicare solo il 5% delle loro ore lavorative alla verifica delle interazioni automatizzate a bassa affidabilità.
Questo processo di revisione continua crea un ciclo di ottimizzazione costante che protegge il vostro marchio:
Identifica i bug nei casi limite ➔ Pulisci i dati di supporto alla fonte ➔ Adegua i limiti di sicurezza dei prompt ➔ Aumenta la precisione della risoluzione
Questo perfezionamento continuo garantisce che i vostri sistemi automatizzati si adattino in modo sicuro alla crescita delle vostre operazioni aziendali. Trasforma il controllo qualità da un centro di costo difensivo a un motore di crescita proattivo per l’intera organizzazione del servizio clienti.
Il percorso strategico verso un’automazione affidabile
La creazione di un sistema di assistenza automatizzata di successo richiede molto più della semplice implementazione di un nuovo strumento software appariscente. La vera trasformazione digitale richiede:
-
Dati testuali puliti
-
Basi di conoscenza strutturate
-
Un quadro di audit disciplinato e basato su metriche.
Dando priorità alla reale accuratezza delle soluzioni fornite dall’IA rispetto a metriche di contenimento ingannevoli, proteggete le relazioni con i clienti e, al contempo, scalate in modo efficiente le vostre operazioni.
Trasformare i registri di assistenza disordinati e obsoleti in un motore automatizzato altamente accurato richiede competenze tecniche approfondite, familiarità con la piattaforma e un'intensa attenzione operativa. È qui che Aspiration Marketing offre un valore fondamentale alla vostra organizzazione.
Ci concentriamo direttamente sulle operazioni di generazione di ricavi, sulle integrazioni tecnologiche complete e sulle strategie di servizio inbound. Aiutiamo le imprese in espansione a verificare i propri dati storici di assistenza, a ripulire complesse pipeline di testo conversazionale, a strutturare le basi di conoscenza interne e a progettare flussi di lavoro affidabili con l’intervento umano.
I nostri team lavorano fianco a fianco con i vostri responsabili dell’assistenza per sostituire le congetture con linee guida basate sui dati. Lasciate che vi aiutiamo a convertire i vostri dati grezzi relativi all’assistenza clienti in una risorsa automatizzata ad alte prestazioni che favorisca una reale efficienza aziendale, un chiaro ritorno sull’investimento e una fedeltà duratura dei clienti.
Lascia un commento
Hai considerazioni su questo articolo?
Condividi il tuo feedback, fai domande o partecipa alla discussione con la nostra community.