

¿Por qué los paneles de control de los proveedores muestran una tasa de resolución del 75 % mientras que tus índices de satisfacción del cliente están bajando? ¿Por qué tus equipos de atención al cliente siguen desbordados por tickets complejos que se han reabierto?
La explicación es bastante sencilla. Tus agentes de atención al cliente no están haciendo bien su trabajo. En absoluto.
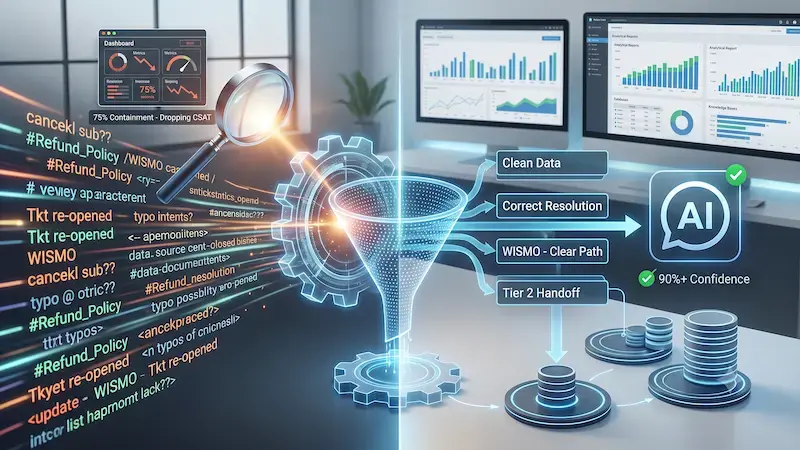 Existe una diferencia enorme y costosa entre la contención y la resolución real. La contención solo significa que una herramienta automatizada ha impedido que un usuario se ponga en contacto con un agente humano. No significa que el sistema haya resuelto realmente el problema del cliente.
Este problema está muy extendido en los entornos modernos de atención al cliente.
Los datos de mercado de Calabrio revelan que hasta el 98 % de los centros de contacto utilizan actualmente algún tipo de inteligencia artificial en sus flujos de trabajo.
Sin embargo,
solo el 12 % de esas organizaciones cuenta con una estrategia de datos totalmente optimizada que lo respalde.
Además,
los informes de Gartner indican que, aunque el 91 % de los responsables de atención al cliente se enfrentan a una fuerte presión por parte de la dirección para implementar herramientas automatizadas, a muchos les cuesta comunicar con confianza al consejo de administración la verdadera precisión de resolución de la IA.
De hecho,
casi el 71 % de los responsables de atención al cliente admiten que no pueden verificar con seguridad sus verdaderas tasas de resolución autónoma ante el consejo de administración.
Esta falta de transparencia se debe a que las auditorías manuales suelen revelar que las métricas automatizadas parecen el doble de buenas de lo que son en realidad cuando no se realiza un seguimiento de los contactos repetidos ni de las escalaciones ocultas.
No se pueden mejorar los sistemas de atención automatizada si los datos de atención al cliente están contaminados. Cuando se entrena o se configura un sistema de IA a partir de registros históricos de tickets desordenados y sin verificar, el rendimiento cae de inmediato. El sistema hereda los errores de tus datos anteriores. Para alcanzar la verdadera eficiencia, debes ir más allá de las simples estadísticas de desviación. Esta guía detallada proporciona un marco riguroso para auditar tus transcripciones de conversaciones, aislar los errores ocultos en casos extremos y limpiar tus datos de atención al cliente subyacentes.
¿Qué es la precisión de resolución de la IA?
Para mejorar tu plataforma automatizada, debes definir con precisión qué estás midiendo. La precisión de resolución de la IA es el porcentaje de interacciones con los clientes que un agente de IA resuelve por completo en el primer intento, sin intervención humana, sin «alucinaciones» ni necesidad de que el usuario vuelva a ponerse en contacto con tu equipo.
Esto es distinto de la tasa de resolución automatizada (ARR) o de la tasa de desviación que se ve en los paneles de control de software estándar. Considera esta fórmula: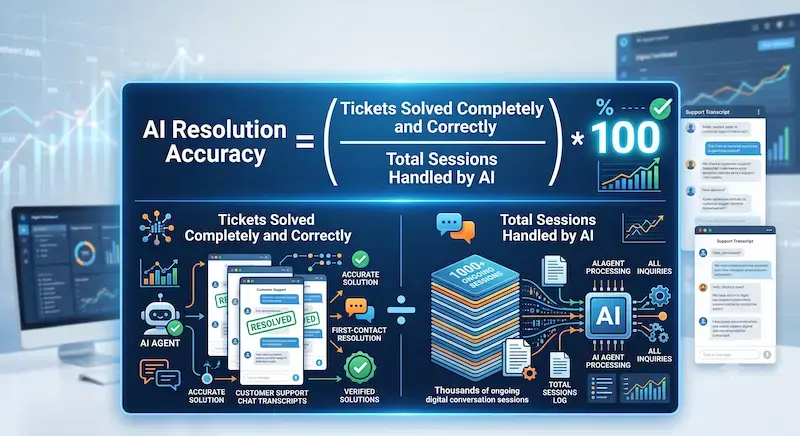 Las plataformas de software estándar suelen registrar un desvío satisfactorio cada vez que un cliente cierra un widget de chat. Pero ¿obtuvo realmente ese cliente su respuesta? ¿O cerró la ventana por pura frustración? La verdadera precisión en la resolución requiere una validación real de los datos. Confirma que la intención del cliente se satisfizo con precisión, de forma segura y en pleno cumplimiento de tus políticas empresariales vigentes.
Por qué los datos de atención al cliente «sucios» distorsionan el rendimiento de la IA
Los datos de atención al cliente son caóticos por naturaleza. Los tickets reales de los clientes están repletos de errores ortográficos, formatos complejos, textos de alerta generados por el sistema y ruido conversacional. A menudo, los clientes agrupan tres solicitudes que no guardan relación entre sí en un único hilo de texto.
Cuando los registros de texto sin procesar ni depurar se introducen en un modelo de lenguaje a gran escala (LLM) o en una base de conocimientos de generación aumentada por recuperación (RAG), el rendimiento se ve afectado. La automatización absorbe respuestas obsoletas, enlaces web inactivos y prácticas de derivación humana inadecuadas.
Es tan sencillo como esto:
Registros de asistencia sucios ➔ Canal de conocimiento RAG ➔ Alucinaciones de la IA y resoluciones erróneas
El riesgo empresarial en este caso es cuantificable.
Un informe sectorial de RevSure revela que el 49 % de los ejecutivos citan las imprecisiones en los datos y el sesgo estructural como las principales barreras para escalar con éxito la IA agentiva.
Una mala higiene de los datos también obliga a las empresas a abandonar por completo las funciones avanzadas.
Un estudio de Gartner indica que, de aquí a 2026, las organizaciones abandonarán hasta el 60 % de los proyectos de IA debido a la falta de datos «preparados para la IA».
Si tus datos de referencia para atención al cliente presentan defectos estructurales, tu lógica automatizada también fallará.
El marco de cuatro pasos para auditar y limpiar los datos de atención al cliente
Puedes eliminar sistemáticamente estos problemas de rendimiento. Utiliza este marco de cuatro pasos para auditar tus transcripciones actuales, eliminar los datos erróneos y proteger tu experiencia automatizada de atención al cliente. De esta forma, tus agentes de atención al cliente, orientados a objetivos, podrán alcanzar realmente sus metas.

Paso 1: Establece tu «verdad fundamental» mediante la revisión manual de las transcripciones
No se puede corregir un sistema automatizado sin una referencia clara de qué constituye una respuesta perfecta. Debes crear un conjunto de datos de «verdad de referencia». Se trata de una recopilación seleccionada de consultas de clientes verificadas, cada una de ellas emparejada con su resolución exacta e ideal.
Empieza por extraer una muestra aleatoria de 500 interacciones autónomas recientes con clientes. No te limites a comprobar si el estado del ticket está marcado como cerrado. Lee directamente el texto de la conversación. Presta especial atención a estos tres modos de fallo ocultos:
-
Abandono silencioso: el cliente dejó de responder por completo porque las respuestas automatizadas resultaban confusas, circulares o repetitivas. Se marchó sin una solución.
-
El bucle de la política: el sistema expuso correctamente la política genérica de la empresa, pero no abordó la excepción específica y práctica que el usuario solicitaba. Esto deja sin resolver el problema principal.
-
El «recontacto en 24 horas»: el sistema cerró la sesión de chat correctamente, pero el cliente abrió un ticket idéntico por correo electrónico o por teléfono en un plazo de 24 horas porque la respuesta inicial no fue satisfactoria.
Documentar estos fallos te ayuda a identificar en qué puntos falla la comprensión de tu sistema en situaciones reales. Cuando descubres estas tendencias, puedes ver claramente la diferencia entre lo que tu panel de control denomina una «desviación» y lo que tu cliente denomina un«fallo».
Paso 2: Limpia y elimina el ruido de tus datos históricos de atención al cliente
Una vez que comprendas los errores habituales de tu sistema, debes limpiar tu base de datos. Este proceso actúa como una lavadora para tus datos de atención al cliente antes de que estos alimenten tu motor de automatización en tiempo real. Piensa en ello como una purga del ruido para que el modelo pueda detectar la señal.
|
Problema con los datos |
Presentación visual en los registros |
Acción de limpieza técnica |
|---|---|---|
|
Infiltración de intenciones |
Las etiquetas que se solapan, como #Política_de_reembolso y #Instrucciones_de_devolución, confunden al modelo. |
Fusionar las categorías idénticas en un único mapa de intenciones mutuamente excluyentes. |
|
Contexto obsoleto |
Estructuras de precios antiguas, enlaces a plataformas inactivas o documentación de productos caducada. |
Elimina por completo los archivos heredados de tus directorios de conocimiento RAG. |
|
Ruido de texto del sistema |
Mensajes internos de automatización del CRM, como «Ticket trasladado a la cola de nivel 2», incluidos en las transcripciones de los usuarios. |
Ejecuta filtros de script automatizados para eliminar los metadatos internos del sistema. |
La limpieza de estos registros garantiza que tu sistema se basa únicamente en información precisa y actualizada. Esto minimiza el riesgo de ofrecer respuestas contradictorias a los clientes.
De hecho, las evaluaciones técnicas de Atlan muestran que,
basar sus modelos en un marco RAG muy limpio y bien mantenido puede reducir las tasas de «alucinaciones» hasta en un 85 % en comparación con los sistemas que no se basan en un marco de este tipo.
Paso 3: Aislar y clasificar las imprecisiones en casos extremos
Las consultas sencillas de los clientes son fáciles de automatizar.
Las consultas estándar como «¿Dónde está mi pedido?» (WISMO) suelen representar entre el 35 % y el 40 % del volumen total de asistencia al cliente en el comercio minorista en línea, según WISMO.
Los sistemas automatizados gestionan estas tareas básicas sin esfuerzo, ya que se conectan directamente a flujos de datos de API predecibles. La verdadera prueba de la precisión de resolución de tu IA reside en el 60 % restante de los escenarios complejos y poco frecuentes de los clientes.
Cuando detecte un error de automatización durante su auditoría de datos, clasifíquelo en una de estas tres categorías operativas específicas:
-
Desajuste contextual: el agente automatizado pasó por alto un detalle crítico en el mensaje del usuario, como confundir una solicitud de cancelación con una de pausa temporal.
-
Lagunas de conocimiento: la información precisa necesaria para resolver el problema del usuario nunca se documentó en los artículos oficiales de la base de conocimientos. La IA se vio obligada a adivinar.
-
Fallos en las medidas de seguridad: el sistema adoptó un estilo conversacional inadecuado, difundió rumores sin verificar sobre actualizaciones de productos o proporcionó asesoramiento transaccional no autorizado.
Clasificar los errores te ayuda a enfocar con precisión las soluciones técnicas. En lugar de adivinar por qué falló el sistema, puedes identificar exactamente qué módulo, mensaje o artículo provocó el fallo. Esto ahorra a tu equipo de desarrollo horas de resolución de problemas sin rumbo fijo.
Paso 4: Implementa controles de clasificación basados en la confianza
No es necesario obligar a tu plataforma automatizada a resolver todas y cada una de las incidencias. Hacerlo es una receta segura para frustrar al cliente. En su lugar, utiliza puntuaciones de confianza en tiempo real para crear un marco de clasificación dinámica. La mayoría de los motores conversacionales avanzados calculan una puntuación de probabilidad interna para cada respuesta que generan, basándose en el grado de coincidencia entre la consulta del usuario y los datos disponibles.
-
Calcular la confianza de la respuesta: el sistema evalúa el texto recibido del cliente en comparación con sus datos de conocimiento disponibles y le asigna una puntuación porcentual de precisión.
-
Aplicar la automatización de alta confianza: si la puntuación calculada supera holgadamente el 90 %, el sistema envía la respuesta de inmediato y resuelve el problema sin intervención humana.
-
Derivar borradores de confianza media: si la puntuación se sitúa entre el 70 % y el 90 %, el sistema redacta un borrador de respuesta y lo deriva a un miembro del equipo humano para su revisión, edición y aprobación antes de que el cliente lo vea.
-
Activar el traspaso en casos de baja confianza: si la puntuación cae por debajo del 70 %, el sistema omite por completo la automatización y transfiere al cliente a un agente humano en tiempo real de forma fluida, con todo el contexto.
Este enfoque de clasificación garantiza un alto nivel de calidad. Al mantener a una persona al tanto de las consultas ambiguas, se evita que la IA cometa errores graves en público.
Convertir los resultados de la auditoría en límites de seguridad para las indicaciones
Una vez identificadas las principales lagunas en los datos, no es necesario volver a entrenar los modelos básicos desde cero. El reentrenamiento es costoso y requiere mucho tiempo. En su lugar, ajusta las restricciones de las indicaciones y las instrucciones del sistema que rigen el comportamiento diario de tu agente humano.
Implementa restricciones negativas estrictas en las indicaciones de tu sistema. Indica al sistema exactamente qué no debe hacer ni decir. Estos límites evitan que el modelo se tome libertades creativas respecto de tus políticas corporativas. Por ejemplo, puedes insertar una directiva operativa precisa como esta en los parámetros básicos de tu sistema:
«Si un cliente solicita modificar un plan de suscripción empresarial, nunca debes citar los niveles de precios estándar al por menor». Transfiere la interacción al equipo de gestión de cuentas de inmediato».
Además, centra tus esfuerzos de optimización directamente en tu documentación de referencia. Si un agente automatizado da una respuesta errónea sobre tu proceso de garantía, la causa principal es casi siempre un artículo ambiguo, confuso u obsoleto del centro de ayuda. Los agentes de IA no inventan nada de la nada; solo amplifican las contradicciones ya presentes en tus archivos. Cuando limpias el texto de la documentación de origen, la precisión de las resoluciones de la IA en tiempo real mejora automáticamente.
Garantía de calidad continua para el éxito a largo plazo
La limpieza de datos nunca es un proyecto puntual. Es un hábito operativo continuo. Tus catálogos internos de productos se actualizan, tus herramientas de software corporativas evolucionan y los comportamientos reales de los clientes cambian con el tiempo. Si tratas la higiene de los datos como un único hito, la precisión de tu automatización se degradará en un plazo de tres a seis meses.
Establece un ritmo estructurado y continuo para el control de calidad. Haz que tus responsables de calidad del servicio de atención al cliente dediquen tan solo el 5 % de su jornada laboral a auditar las interacciones automatizadas de baja fiabilidad.
Este proceso de revisión continua crea un ciclo de optimización constante que protege tu marca:
Identificar errores en casos extremos ➔ Limpiar los datos de origen del servicio de atención al cliente ➔ Ajustar los límites de seguridad de las respuestas automáticas ➔ Aumentar la precisión en la resolución
Este perfeccionamiento continuo garantiza que tus sistemas automatizados se adapten de forma segura a medida que crecen tus operaciones empresariales. Convierte el control de calidad de un centro de costes defensivo en un motor de crecimiento proactivo para toda tu organización de atención al cliente.
El camino estratégico hacia una automatización fiable
Crear un sistema de asistencia automatizado eficaz requiere algo más que la simple implementación de una nueva y llamativa herramienta de software. La verdadera transformación digital exige:
-
Datos de texto limpios
-
Bases de conocimiento estructuradas
-
Un marco de auditoría disciplinado y basado en métricas.
Al dar prioridad a la precisión real de la resolución mediante IA frente a métricas de contención engañosas, proteges tus relaciones con los clientes al tiempo que amplías tus operaciones de forma eficiente.
Transformar los desordenados registros de asistencia heredados en un motor automatizado de gran precisión requiere profundidad técnica, familiaridad con la plataforma y un intenso enfoque operativo. Aquí es donde Aspiration Marketing aporta un valor fundamental a tu organización.
Nos centramos directamente en las operaciones de ingresos, las integraciones tecnológicas integrales y las estrategias de servicio de entrada. Ayudamos a las empresas en expansión a auditar sus datos históricos de atención al cliente, depurar flujos de texto conversacional complejos, estructurar bases de conocimiento internas y diseñar flujos de trabajo fiables con intervención humana.
Nuestros equipos trabajan codo con codo con sus responsables de atención al cliente para sustituir las conjeturas por directrices basadas en datos. Déjenos ayudarle a convertir sus datos brutos de atención al cliente en un activo automatizado de alto rendimiento que impulse una eficiencia empresarial real, un retorno de la inversión claro y una fidelidad duradera de los clientes.
Deja un comentario
¿Tiene algún comentario sobre este artículo?
Comparta sus comentarios, haga preguntas o únase a la discusión con nuestra comunidad.