

Wie ermitteln moderne Suchmaschinen und KI-Suchmaschinen tatsächlich, wem ein Thema gehört? Wenn Sie sich nach wie vor auf die traditionelle Keyword-Dichte oder isolierte Tagstrukturen verlassen, könnten Ihre Inhalte für moderne Large Language Models (LLMs) und semantische Such-Crawler völlig unsichtbar sein.
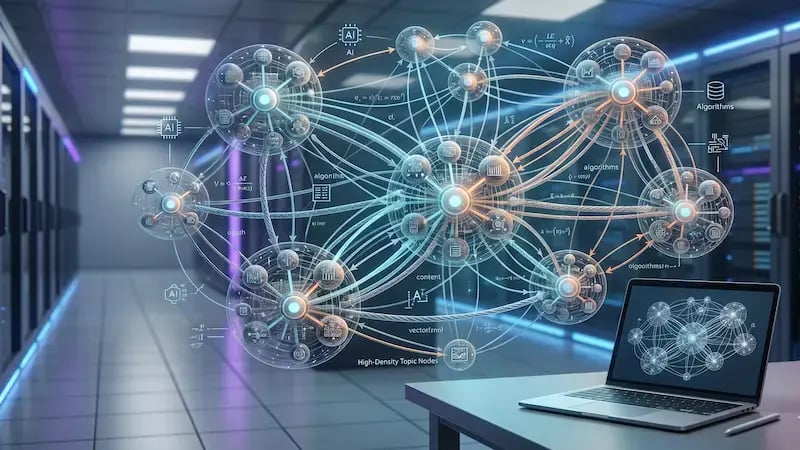 Die digitale Landschaft hat sich grundlegend verändert. Wir sind von einer Ära einfacher Textzeichenfolgen zu einem komplexen Netz miteinander verbundener Elemente übergegangen –technisch als „Entitäten“ bezeichnet. KI-Suchwerkzeuge durchsuchen Ihren Text nicht mehr nur nach exakten Übereinstimmungen von Wortgruppen. Stattdessen betrachten sie die gesamte Website-Struktur, um eine digitale Karte zu erstellen. Diese Karte ist ein Wissensgraph, wie Datenwissenschaftler ihn nennen.
Wenn das Layout Ihrer Website nicht klar strukturiert ist, suchen KI-Crawler einfach anderswo nach Antworten. Für moderne Digitalteams steht unglaublich viel auf dem Spiel.
Eine umfassende Studie von SparkToro und Datos ergab, dass Zero-Click-Suchen auf Desktop-Geräten auf fast 58,5 % und auf mobilen Plattformen sogar auf erstaunliche 77,1 % angestiegen sind.
Das bedeutet, dass KI-Zusammenfassungen, direkte Antworten und „Featured Snippets“ den Großteil der Nutzeraufmerksamkeit auf sich ziehen.
Um diesen Wandel zu überstehen, müssen sich Ihre Inhalte ändern. Es reicht nicht mehr aus, einzelne Artikel zu verfassen. Sie müssen themenbezogene Knotenpunkte mit hoher Dichte aufbauen, die auf mathematischer Präzision basieren. Dieser Ansatz stellt sicher, dass KI-Modelle Ihre Marke ganz selbstverständlich als maßgebliche Autorität in Ihrem Bereich erkennen.
Wissensgraphen und semantische Dichte entmystifizieren
Um zu verstehen, wie man heute Autorität aufbaut, müssen wir zunächst die Kernmechanismen der KI-Indizierung aufschlüsseln. Was genau ist ein Wissensgraph im Kontext moderner KI im Content-Marketing?
Im einfachsten Fall ist ein Wissensgraph ein Netzwerk aus Entitäten der realen Welt und den Beziehungen zwischen ihnen. Stellen Sie sich das als eine riesige Mindmap vor, die eine KI nutzt, um menschliche Sprache zu verstehen. In diesem Netzwerk kann eine „Entität“ eine Person, ein Ort, eine Organisation oder ein Konzept sein. Die Verbindungen zwischen diesen Entitäten werden als „Kanten“ bezeichnet. Beispielsweise ist„KI im Content-Marketing“ eine Entität, „Wissensgraphen“ eine weitere Entität, und die Verbindung zwischen ihnen ist eine funktionale Beziehung.
Wenn ein KI-Crawler Ihre Website besucht, versucht er, Ihre Inhalte in seinen internen Graphen zu modellieren. Hier kommt das Konzept eines Themenknotens mit hoher Dichte ins Spiel. Ein Themenknoten ist ein Cluster von Inhalten, der sich um ein Kernthema dreht. Er wird als „hochdicht“ bezeichnet, wenn er eine reichhaltige, mathematisch validierte Konzentration eng miteinander verbundener Unterthemen, kontextbezogener Begriffe und struktureller Definitionen enthält.
KI-Suchmaschinen legen Wert auf semantische Dichte, da sie auf Vektorraummodellen basieren. Modelle wie Google Gemini oder OpenAI GPT-4 analysieren, wie eng Konzepte in einem mehrdimensionalen mathematischen Raum miteinander verbunden sind. Wenn Ihr Content-Hub-Cluster mit hoher Dichte und ohne Informationslücken vorhanden ist, weist die KI Ihrer Website einen hohen Konfidenzwert zu.
Die geschäftlichen Vorteile dieses architektonischen Ansatzes liegen auf der Hand.
Laut einem Bericht von Gartner zur Unternehmenstechnologie können Organisationen, die Active-Data-Graph-Technologien zur Verknüpfung unterschiedlicher Datenquellen einsetzen, die Datenvorbereitungszeiten um bis zu 30 % reduzieren und gleichzeitig die semantische Klarheit erheblich verbessern.
Bei direkter Anwendung auf Content-Systeme bedeutet dies, dass Suchmaschinen-Bots Ihre gesamte Ressourcenbibliothek 30 % schneller crawlen, indexieren und verstehen können, was zu schnellen Autoritätssignalen führt.
Um diese Struktur ordnungsgemäß aufzubauen, müssen Sie eine saubere Datenebene als Fundament Ihres Unternehmens etablieren. Sind Ihre zugrunde liegenden Content-Systeme unübersichtlich oder nicht miteinander verbunden, bricht Ihr Wissensgraph zusammen. Beispielsweise haben große Unternehmen oft mit fragmentierten Kundendaten und verstreuten Content-Assets zu kämpfen. Durch die systematische Optimierung der HubSpot-CMS- und CRM-Daten für KI-Antworten schaffen Sie eine einheitliche Datengrundlage. Dadurch können Ihre Content-Management-Systeme saubere, strukturierte Informationen direkt an semantische Web-Crawler weiterleiten.
Die Mathematik der Themenmodellierung
Wie lesen und bewerten KI-Crawler Ihre Website eigentlich? Sie lesen nicht Zeile für Zeile, wie Menschen es tun. Stattdessen wenden sie komplexe Algorithmen an, um die mathematische Verteilung der Themen auf Ihren Seiten zu bewerten.
Eines der grundlegenden Rahmenwerke für diesen Prozess ist die Latent Dirichlet Allocation (LDA) neben modernen, auf Transformern basierenden Wort-Embeddings wie BERT und RoBERTa. Vereinfacht ausgedrückt analysieren diese Systeme das statistische gemeinsame Vorkommen von Wörtern in Millionen von Dokumenten. Die mathematische Annahme lautet: Wenn bestimmte Wörter häufig in der Nähe beieinander vorkommen, gehören sie zum selben zugrunde liegenden, verborgenen Thema.
Betrachten wir ein praktisches Beispiel. Wenn Ihr zentrales Inhaltsthema„KI im Content-Marketing“ lautet, erwartet ein Algorithmus eine hochgradig vorhersehbare mathematische Verteilung verwandter Entitäten auf derselben Seite oder innerhalb desselben Clusters. Wenn Ihre Inhalte lediglich grundlegende Marketingbegriffe erwähnen, weist Ihre Textmenge eine geringe semantische Dichte auf. Wenn Ihre Seiten jedoch auf natürliche Weise sekundäre und tertiäre Entitäten wie „retrieval-augmented generation“, „Vektordatenbanken“, „natürliche Sprachverarbeitung“ und „strukturierter Schema-Strukturcode“ einbeziehen, steigt der mathematische Nähewert drastisch an.
Das ultimative Ziel dieser mathematischen Analyse ist die absolute Dominanz in der jeweiligen Kategorie. Wenn ein Suchbot Ihren Knoten mit hoher Dichte scannt und ein vollständiges, lückenloses Netz verwandter Definitionen vorfindet, stellt er die Suche nach externen Quellen zur Validierung der Antworten ein. Er erkennt, dass Ihre Website die maßgebliche Anlaufstelle für diese Kategorie ist.
Um diesen Unterschied zu veranschaulichen, betrachten Sie den Vergleich zwischen einem traditionellen, auf Schlüsselwörter ausgerichteten Content-Hub und einem mathematisch optimierten semantischen Knoten:
| Attribut | Traditioneller Keyword-Hub | Semantischer Knoten mit hoher Dichte |
|---|---|---|
| Hauptschwerpunkt | Keywords mit hohem Suchvolumen | Kernentitäten und Beziehungskarten |
| Interne Verlinkung | Zufällige Querverweise oder lineare Ketten | Eng verwobene semantische Cluster (Kanten) |
| Crawler-Interaktion | Durchsucht den Text nach exakten Phrasenübereinstimmungen | Berechnet semantischen Abstand und Vektorposition |
| Benutzererfahrung | Fragmentierte Artikel zu einzelnen Themen | Nahtlose, umfassende Wissensreise |
| AEO-Leistung | Geringe Sichtbarkeit in direkten KI-Zusammenfassungen | Hohe Einbeziehungsraten in direkten KI-Antworten |
Indem Sie sich stark auf die mathematischen Zusammenhänge zwischen Konzepten konzentrieren, verwandeln Sie Ihren Text aus einer Sammlung einfacher Blogbeiträge in eine leistungsstarke Wissensdatenbank, die von Algorithmen problemlos verarbeitet werden kann.
Schritt für Schritt: Aufbau hochdichter Themenknoten
Der Aufbau dieser fortgeschrittenen semantischen Strukturen erfordert eine durchdachte, schrittweise Methodik. Sie müssen die Erstellung von Inhalten mit der Denkweise eines Dateningenieurs angehen. So können Sie systematisch themenbezogene Knoten mit hoher Dichte aufbauen, die sowohl menschliche Leser als auch Suchmaschinen zufriedenstellen.
1. Entitäts-Extraktion und Recherche:
Phase 1: Entdeckung.
Beginnen Sie damit, Ihre übergeordnete Entität zu identifizieren. Anstatt sich ausschließlich auf herkömmliche Keyword-Tools zu verlassen, lassen Sie Ihr Thema durch semantische Extraktions-Engines und Open-Source-Wissensdatenbanken wie Wikidata laufen.
Identifizieren Sie die 10 wichtigsten sekundären Entitäten und die 30 wichtigsten tertiären Begriffe, die mathematisch gesehen gemeinsam mit Ihrem Hauptthema auftreten. So erhalten Sie eine umfassende Übersicht über den Wortschatz, der erforderlich ist, um eine absolute Kategoriedominanz nachzuweisen.
2. Aufbau der internen Verlinkungsstruktur:
Phase 2: Strukturelle Verlinkung.
Verbinden Sie Ihre Content-Elemente mithilfe einer straffen Link-Architektur. Jede Unterseite muss über einen kontextreichen Ankertext auf den zentralen Säulenknoten verweisen. Noch wichtiger ist, dass verwandte Unterseiten horizontal miteinander verknüpft werden, um einen geschlossenen semantischen Kreislauf zu bilden. Diese internen Verlinkungen fungieren als strukturelle Kanten in Ihrem Wissensgraphen und signalisieren KI-Crawlern, dass all diese Ressourcen zu einem einheitlichen Ökosystem gehören.
3. Optimierung der technischen Lesbarkeit:
Phase 3: Erstellung von Inhalten.
Verfassen Sie Ihre Inhalte in einem übersichtlichen, barrierefreien Layout, das es LLMs ermöglicht, Schlüssel-Wert-Paare problemlos zu extrahieren. Verwenden Sie beschreibende Substantive anstelle von mehrdeutigen Pronomen wie „es“ oder „dies“. Strukturieren Sie Ihre Antworten direkt unter expliziten H2- und H3-Fragen, um die Textverarbeitung für Abrufmodelle zu vereinfachen. Achten Sie auf eine klare, prägnante und direkte Sprache, um die Lesbarkeit sowohl für Menschen als auch für Maschinen zu maximieren.
4. Einsatz eines erweiterten JSON-LD-Schemas:
Phase 4: Technische Einbindung.
Übersetzen Sie Ihr Inhaltslayout in eine Sprache, die Suchmaschinen sofort lesen können, ohne den Text zu verarbeiten. Fügen Sie erweiterte JSON-LD-Strukturdaten in den Header-Code Ihrer Seiten ein. Verwenden Sie die Schema-Eigenschaften „about“ und „mentions“, um die genauen Wikidata-Einträge, auf die sich Ihr Text bezieht, explizit zu benennen. Dies gibt Such-Bots einen klaren Überblick über Ihren Themenknoten, noch bevor sie auch nur ein einziges Wort lesen.

Während Sie diese Schritte umsetzen, werden Sie vielleicht feststellen, dass die Erstellung dieser Menge an dichtem Inhalt von Grund auf sehr ressourcenintensiv ist. Glücklicherweise können Sie diesen Prozess effizient skalieren, indem Sie auf bestehende digitale Assets zurückgreifen. So ist beispielsweise die Umwandlung Ihrer umfangreichen Videobibliotheken in globale AEO-Blog-Cluster eine hervorragende Möglichkeit. Indem Sie Langform-Webinare oder Unternehmensschulungsvideos nutzen, Transkripte extrahieren und diese zu eng miteinander verknüpften semantischen Textartikeln organisieren, können Sie in einem Bruchteil der Zeit einen maßgeblichen Wissensgraphen aufbauen.
Da Ihre Inhaltsbibliothek jedoch über mehrere Regionen hinweg wächst, müssen Sie einer semantischen Verwässerung vorbeugen. Wenn verschiedene Teams ohne Abstimmung sich überschneidende Artikel veröffentlichen, wird Ihr Wissensgraph unübersichtlich und für KI-Crawler verwirrend. Durch die Implementierung einer strengen, KI-gestützten globalen Content-Governance können Sie saubere Datenstrukturen aufrechterhalten, die Kannibalisierung von Inhalten verhindern und Ihre digitalen Assets skalieren, ohne strukturelles Chaos zu verursachen.
Erfolgsmessung: Die 90-tägige Content-Entwicklung
Wie messen Sie die Leistung Ihrer hochdichten Themenknoten, sobald Sie diese bereitgestellt haben? Herkömmliche Tracking-Kennzahlen, wie beispielsweise einfache Keyword-Rankings, geben in einem KI-gesteuerten Suchökosystem keinen vollständigen Überblick.
Um Ihre Dominanz in der Kategorie wirklich einzuschätzen, müssen Sie den Fokus Ihrer Analysen auf die Nachverfolgung neuer Sichtbarkeitssignale verlagern. Überwachen Sie Ihre Impressionen in der Search Console gezielt für Long-Tail-Informationsanfragen und fragebasierte Phrasen. Noch wichtiger ist es, moderne Überwachungstools zu nutzen, um zu verfolgen, wie oft Ihre Marke in KI-generierten Zusammenfassungen erwähnt wird, etwa in Googles „Search Generative Experience“, bei Perplexity oder Copilot.
| 90-TAGE-ÜBERSICHT ZUR INHALTSENTWICKLUNG |
| Monat 1: Audit & Cluster-Karten |
| Monat 2: Strukturelle Verbindungen & Kanten |
| Monat 3: Dominanz von KI-Antworten |
Diese strukturelle Transformation geschieht nicht über Nacht. Die Abkehr von einer veralteten, mit Schlüsselwörtern überladenen Bibliothek erfordert ein klares Rahmenkonzept. Die Durchführung einer KI-gesteuerten Content-Aktualisierung dient als zuverlässiger 90-Tage-Fahrplan.
1. Konzentrieren Sie sich in den ersten 30 Tagen darauf, Ihre bestehenden Inhalte zu prüfen und Ihre Zielentitäten zu erfassen.
2. Im zweiten Monat sollten Sie Ihre interne Linkarchitektur optimieren, um Ihre Verknüpfungen zu erstellen.
3. Im dritten Monat sollten Sie fortgeschrittene technische Schemata einbinden und die semantische Lesbarkeit optimieren.
Innerhalb von 90 Tagen verwandelt dieser systematische Ansatz unzusammenhängende Webseiten in einen äußerst maßgeblichen Wissensgraphen.
Die neue Ära der KI-Suchstrategie meistern
Die Welt der Content-Erstellung hat sich über das einfache Abgleichen von Schlüsselwörtern hinaus weiterentwickelt. Um heute in der Suchlandschaft erfolgreich zu sein, muss ein zuverlässiges, mathematisch dichtes Informationsnetzwerk aufgebaut werden, das Suchroboter mühelos lesen können. Durch die Erstellung hochdichter Themenknoten hören Sie auf, volatilen Algorithmus-Updates hinterherzulaufen, und schaffen stattdessen einen dauerhaften digitalen Fußabdruck, der Autorität ausstrahlt.
Die Strukturierung einer derart tiefgreifenden technischen Inhaltsarchitektur erfordert einzigartiges Fachwissen sowohl in fortgeschrittenen KI-Mechanismen als auch in der Integration von Unternehmensplattformen. Genau hier bietet Aspiration Marketing entscheidenden Mehrwert. Aspiration Marketing unterstützt wachstumsorientierte Unternehmensmarken dabei, ausgefeilte, KI-orientierte Inhaltsframeworks zu entwerfen, zu verwalten und umzusetzen, die sich nahtlos in moderne Wissensgraphen integrieren lassen. Wenn Sie bereit sind, das Rätselraten hinter sich zu lassen und Ihre Marktkategorie mit einer datengesteuerten Strategie zu dominieren, wenden Sie sich noch heute an die Spezialisten für Unternehmenswachstum bei Aspiration Marketing, um Ihre semantische Zukunft zu gestalten.
Kommentar hinterlassen
Haben Sie Fragen oder Kommentare?
Teilen Sie Ihr Feedback, stellen Sie Fragen oder diskutieren Sie mit unserer Community.