

Pourquoi les tableaux de bord des fournisseurs affichent-ils un taux de résolution de 75 % alors que vos scores de satisfaction client sont en baisse ? Pourquoi vos équipes d'assistance humaine sont-elles toujours submergées par des tickets complexes rouverts ?
L'explication est assez simple. Vos agents du service client ne font pas du bon travail. Pas du tout.
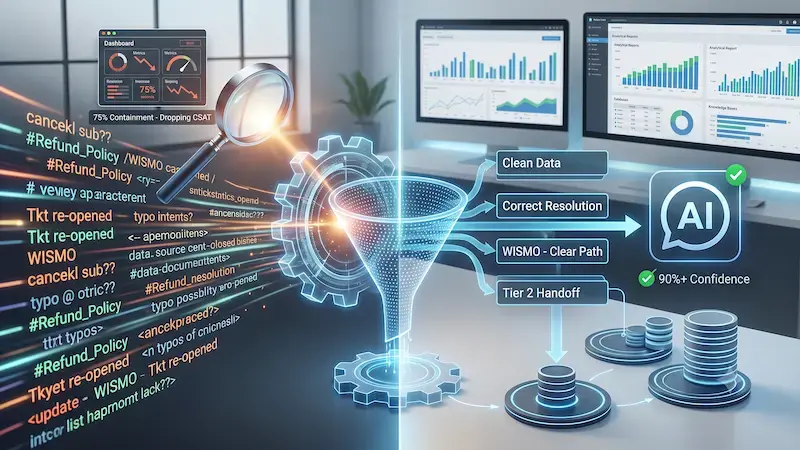 Il existe une différence considérable et coûteuse entre la résolution initiale et la résolution effective. La résolution initiale signifie simplement qu’un outil automatisé a empêché un utilisateur de contacter un agent humain. Cela ne signifie pas que le système a réellement résolu le problème du client.
Ce problème est très répandu dans les structures d’assistance modernes.
Les données de marché de Calabrio révèlent que jusqu’à 98 % des centres de contact déploient désormais une forme ou une autre d’intelligence artificielle au sein de leurs workflows.
Cependant,
seules 12 % de ces organisations disposent d’une stratégie de données pleinement optimisée pour soutenir cette initiative.
De plus,
les rapports de Gartner indiquent que, bien que 91 % des responsables du service client subissent une forte pression de la part de la direction pour déployer des outils automatisés, beaucoup peinent à communiquer en toute confiance au conseil d’administration le taux de résolution réel de l’IA.
En effet,
près de 71 % des responsables du service client admettent ne pas être en mesure de vérifier avec certitude leurs véritables taux de résolution autonome auprès du conseil d’administration.
Ce manque de transparence s’explique par le fait que les audits manuels révèlent souvent que les indicateurs automatisés semblent deux fois meilleurs que la réalité lorsque l’on ne suit ni les contacts répétés ni les escalades cachées.
Vous ne pouvez pas améliorer vos systèmes d’assistance automatisés si vos données relatives au service client sont erronées. Lorsque vous entraînez ou basez un système d’IA sur des historiques de tickets désordonnés et non vérifiés, les performances chutent immédiatement. Le système hérite de vos erreurs passées en matière de données. Pour atteindre une véritable efficacité, vous devez aller au-delà des simples statistiques de déviation. Ce guide approfondi fournit un cadre rigoureux pour auditer vos transcriptions de conversations, isoler les erreurs cachées dans les cas limites et nettoyer vos données d’assistance sous-jacentes.
Qu’est-ce que la précision de résolution de l’IA ?
Pour améliorer votre plateforme automatisée, vous devez définir précisément ce que vous mesurez. La précision de résolution de l’IA correspond au pourcentage d’interactions client qu’un agent IA résout complètement dès la première tentative, sans intervention humaine, sans « hallucinations » et sans que l’utilisateur ait à recontacter votre équipe.
Ce concept est distinct du taux de résolution automatisée (ARR) ou du taux de déviation que vous voyez dans les tableaux de bord logiciels standard. Considérez cette formule :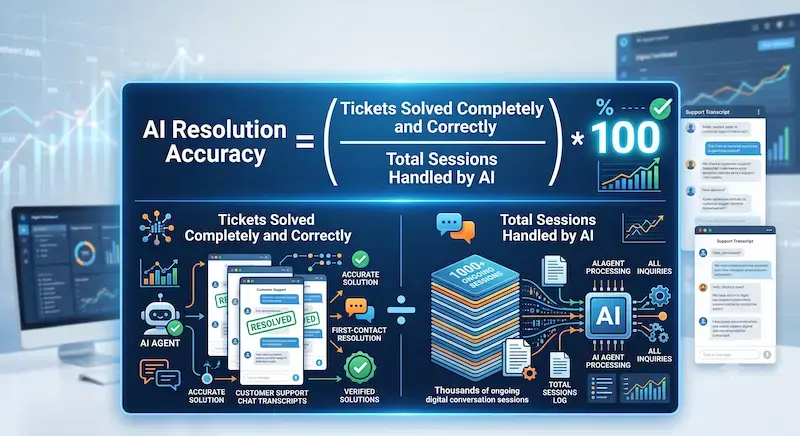 Les plateformes logicielles standard enregistrent souvent un détournement réussi dès qu’un client ferme un widget de chat. Mais ce client a-t-il réellement obtenu sa réponse ? Où a-t-il fermé la fenêtre par pure frustration ? La véritable précision de résolution requiert une validation rigoureuse des données. Elle confirme que l’intention du client a été satisfaite avec précision, en toute sécurité et en totale conformité avec vos politiques d’entreprise en vigueur.
Pourquoi des données d’assistance « erronées » faussent les performances de l’IA
Les données de support client sont par nature chaotiques. Les véritables tickets clients regorgent de fautes de frappe, de mises en forme complexes, de textes d’alerte générés par le système et de bruit conversationnel. Les clients regroupent souvent trois demandes sans rapport entre elles dans un seul fil de discussion.
Lorsque des journaux de texte bruts et non nettoyés sont intégrés à un grand modèle linguistique (LLM) ou à une base de connaissances de type « Retrieval-Augmented Generation » (RAG), les performances en pâtissent. L’automatisation intègre alors des réponses obsolètes, des liens web morts et des habitudes de routage inappropriées des agents.
C’est aussi simple que cela :
Journaux d’assistance non nettoyés ➔ Pipeline de connaissances RAG ➔ Hallucinations de l’IA et résolutions erronées
Le risque pour l’entreprise est ici mesurable.
Un rapport sectoriel de RevSure révèle que 49 % des dirigeants citent les inexactitudes des données et les biais structurels comme principaux obstacles à la mise en œuvre réussie d’une IA agentique à grande échelle.
Une mauvaise hygiène des données oblige également les entreprises à renoncer complètement à certaines fonctionnalités avancées.
Une étude de Gartner indique que d’ici 2026, les organisations abandonneront jusqu’à 60 % de leurs projets d’IA en raison d’un manque de données « prêtes pour l’IA ».
Si vos données de base relatives au support client présentent des défauts structurels, votre logique automatisée sera elle aussi défaillante.
Le cadre en 4 étapes pour auditer et nettoyer les données du service client
Vous pouvez éliminer systématiquement ces problèmes de performance. Utilisez ce cadre en quatre étapes pour auditer vos transcriptions actuelles, éliminer les données erronées et protéger votre expérience client automatisée. Ainsi, vos agents du service client, axés sur les résultats, pourront réellement les atteindre.

Étape 1 : Établissez votre « vérité de référence » via une révision manuelle des transcriptions
Vous ne pouvez pas corriger un système automatisé sans référence claire à ce qui constitue une réponse parfaite. Vous devez constituer un ensemble de données de «référence ». Il s’agit d’une collection triée sur le volet de demandes clients vérifiées, chacune étant associée à sa résolution exacte et idéale.
Commencez par prélever un échantillon aléatoire de 500 interactions récentes avec des clients gérées de manière autonome. Ne vous contentez pas de vérifier si le statut du ticket est marqué comme « clôturé ». Lisez directement le texte de la conversation. Recherchez attentivement ces trois types d’échecs cachés:
-
Abandon silencieux : le client a cessé de répondre, car les réponses automatisées étaient confuses, circulaires ou répétitives. Il est parti sans solution.
-
La boucle de la politique d’entreprise : le système a correctement énoncé une politique d’entreprise générale, mais n’a pas su traiter l’exception spécifique et concrète demandée par l’utilisateur. Le problème fondamental reste ainsi non résolu.
-
Le « recontact dans les 24 heures » : le système a clôturé la session de chat de manière correcte, mais le client a ouvert un ticket identique par e-mail ou par téléphone dans les 24 heures, car la réponse initiale s’est avérée inefficace.
Documenter ces échecs vous aide à identifier les points où la compréhension de votre système présente des lacunes dans des situations réelles. Lorsque vous mettez en évidence ces tendances, vous pouvez clairement voir l’écart entre ce que votre tableau de bord appelle une «déviation » et ce que votre client appelle un «échec ».
Étape 2 : Nettoyer et filtrer vos données historiques d’assistance
Une fois que vous avez identifié les erreurs courantes de votre système, vous devez nettoyer votre base de données. Ce processus agit comme une machine à laver pour vos données de service client avant qu’elles n’alimentent votre moteur d’automatisation en temps réel. Considérez cela comme une purge du bruit afin que le modèle puisse percevoir le signal.
|
Problème lié aux données |
Présentation visuelle dans les journaux |
Action de nettoyage technique |
|---|---|---|
|
Infiltration d’intentions |
Des balises qui se chevauchent, telles que #Refund_Policy et #Return_Instructions, introduisent de la confusion dans le modèle. |
Fusionner les catégories identiques en une seule carte d’intentions mutuellement exclusive. |
|
Contexte obsolète |
Anciennes structures tarifaires, liens vers des plateformes inactives ou documentation produit périmée. |
Supprimez complètement les fichiers obsolètes de vos répertoires de connaissances RAG. |
|
Bruit textuel du système |
Messages d’automatisation CRM internes, tels que «Ticket déplacé vers la file d’attente de niveau 2 », dans les transcriptions des utilisateurs. |
Exécutez des filtres automatisés pour supprimer les métadonnées internes du système. |
Le nettoyage de ces enregistrements garantit que votre système s'appuie uniquement sur des informations précises et à jour. Cela minimise le risque de fournir des réponses contradictoires aux clients.
En effet, les évaluations techniques menées par Atlan montrent que,
le fait d’ancrer vos modèles dans un cadre RAG très propre et bien entretenu peut réduire les taux d’hallucination jusqu’à 85 % par rapport aux systèmes non ancrés.
Étape 3 : isoler et classer les inexactitudes liées aux cas limites
Les demandes simples des clients sont faciles à automatiser.
Les demandes standard telles que « Où en est ma commande ? » (WISMO) représentent généralement entre 35 % et 40 % du volume total de l’assistance en ligne dans le secteur de la vente au détail, selon WISMO.
Les systèmes automatisés gèrent ces tâches de base sans difficulté, car ils se connectent directement aux flux de données via des API prévisibles. Le véritable test de la précision de votre IA réside dans les 60 % restants de scénarios clients complexes et de niche.
Lorsque vous repérez une erreur d’automatisation lors de votre audit des données, classez-la dans l’une de ces trois catégories opérationnelles spécifiques :
-
Incohérence contextuelle : l’agent automatisé a omis un détail essentiel dans le message de l’utilisateur, par exemple en confondant une demande d’annulation avec une demande de suspension temporaire.
-
Lacunes dans les connaissances : les informations précises nécessaires pour résoudre le problème de l’utilisateur n’ont jamais été documentées dans les articles de votre base de connaissances officielle. L’IA a été contrainte de deviner.
-
Défaillances des garde-fous : le système a adopté un style conversationnel inapproprié, a relayé des rumeurs non vérifiées concernant des mises à jour de produits ou a fourni des conseils transactionnels non autorisés.
La catégorisation de vos erreurs vous aide à cibler précisément vos corrections techniques. Au lieu de deviner pourquoi le système a échoué, vous pouvez identifier précisément quel module, quelle invite ou quel article a provoqué la défaillance. Cela évite à votre équipe de développement des heures de dépannage à l’aveuglette.
Étape 4 : Déployer des contrôles de triage basés sur la confiance
Vous n’avez pas à forcer votre plateforme automatisée à traiter chaque ticket. Cela ne ferait qu’engendrer la frustration des clients. Utilisez plutôt des scores de confiance en temps réel pour mettre en place un cadre de triage dynamique. La plupart des moteurs conversationnels avancés calculent un score de probabilité interne pour chaque réponse qu’ils génèrent, en fonction de l’adéquation entre la requête de l’utilisateur et les données disponibles.
-
Calcul de la confiance de la réponse : le système évalue le message reçu du client au regard de ses données de connaissances et lui attribue un score de précision, exprimé en pourcentage.
-
Exécuter l’automatisation à haute confiance : si le score calculé est largement supérieur à 90 %, le système envoie la réponse instantanément et résout le problème sans intervention humaine.
-
Transmettre les brouillons à confiance moyenne : si le score se situe entre 70 % et 90 %, le système rédige un brouillon de réponse et le transmet à un agent humain pour révision, modification et validation avant que le client ne le voie.
-
Déclencher le transfert en cas de faible confiance : si le score tombe en dessous de 70 %, le système contourne entièrement l’automatisation et transfère le client de manière transparente à un agent humain, en lui fournissant l’intégralité du contexte.
Cette approche de triage vous garantit de maintenir un niveau de qualité élevé. En conservant une intervention humaine pour les requêtes ambiguës, vous évitez que l’IA ne commette des erreurs manifestes en public.
Transformer les conclusions d’audit en lignes directrices pour les invités
Une fois que vous avez identifié vos principales lacunes en matière de données, vous n’avez pas besoin de réentraîner vos modèles de base à partir de zéro. Le réentraînement est coûteux et chronophage. Ajustez plutôt les garde-fous des invites et les instructions système qui régissent le comportement quotidien de votre agent en direct.
Mettez en place des contraintes négatives strictes dans les consignes de votre système. Indiquez précisément au système ce qu’il ne doit ni faire ni dire. Ces limites empêchent le modèle de prendre des libertés créatives au regard de vos politiques d’entreprise. Par exemple, vous pouvez insérer une directive opérationnelle précise comme celle-ci dans les paramètres de base de votre système :
« Si un client demande à modifier un forfait d’abonnement d’entreprise, vous ne devez en aucun cas mentionner les barèmes tarifaires standard destinés au grand public. Transférez immédiatement l’interaction à l’équipe de gestion des comptes. »
De plus, concentrez vos efforts d’optimisation directement sur votre documentation source. Si un agent automatisé donne une réponse erronée concernant votre processus de garantie, la cause première est presque toujours un article du centre d’aide ambigu, prêtant à confusion ou obsolète. Les agents d’IA n’inventent pas de choses de toutes pièces ; ils amplifient les contradictions déjà présentes dans vos fichiers. Lorsque vous nettoyez le texte de la documentation source, la précision des résolutions en temps réel de votre IA s’améliore automatiquement.
Une assurance qualité continue pour un succès à long terme
Le nettoyage des données n’est jamais un projet ponctuel. Il s’agit d’une pratique opérationnelle continue. Vos catalogues de produits internes sont mis à jour, vos outils logiciels d’entreprise évoluent et les comportements réels des clients évoluent au fil du temps. Si vous considérez l’hygiène des données comme une étape unique, la précision de votre automatisation se dégradera dans un délai de trois à six mois.
Mettez en place un rythme structuré et continu d’assurance qualité. Demandez à vos responsables de la qualité du support de consacrer uniquement 5 % de leur temps de travail à l’audit des interactions automatisées présentant un faible niveau de confiance.
Ce processus de révision continue crée une boucle d’optimisation permanente qui protège votre marque :
Identifier les bugs liés aux cas limites ➔ Nettoyer les données sources du service client ➔ Ajuster les garde-fous des invites ➔ Améliorer la précision des résolutions
Ce perfectionnement continu garantit que vos systèmes automatisés évoluent en toute sécurité à mesure que vos activités commerciales se développent. Il transforme l’assurance qualité, qui passe d’un centre de coûts défensif à un moteur de croissance proactif pour l’ensemble de votre service client.
La voie stratégique vers une automatisation fiable
La mise en place d’un système d’assistance automatisé performant ne se limite pas au simple déploiement d’un nouvel outil logiciel tape-à-l’œil. Une véritable transformation numérique exige :
-
Des données textuelles propres
-
Des bases de connaissances structurées
-
Un cadre d’audit rigoureux, fondé sur des indicateurs.
En privilégiant la précision réelle des résolutions d’IA plutôt que des indicateurs de confinement trompeurs, vous préservez vos relations avec les clients tout en optimisant vos opérations.
Transformer des journaux d’assistance hérités et désorganisés en un moteur automatisé hautement précis nécessite une expertise technique approfondie, une bonne maîtrise de la plateforme et une concentration opérationnelle intense. C’est là qu’Aspiration Marketing apporte une valeur ajoutée essentielle à votre organisation.
Nous nous concentrons directement sur les opérations de génération de chiffre d’affaires, les intégrations technologiques complètes et les stratégies de service « inbound ». Nous aidons les entreprises en pleine expansion à auditer leurs données historiques d’assistance, à nettoyer les flux de texte conversationnels complexes, à structurer leurs bases de connaissances internes et à concevoir des workflows fiables intégrant l’intervention humaine.
Nos équipes travaillent en étroite collaboration avec vos responsables du support pour remplacer les approximations par des garde-fous fondés sur les données. Laissez-nous vous aider à transformer vos données brutes de support client en un outil automatisé hautement performant qui génère une réelle efficacité opérationnelle, un retour sur investissement clair et une fidélité durable de la clientèle.

Laisser un commentaire
Une réaction à cet article ?
Partagez votre avis, posez des questions ou rejoignez la discussion avec notre communauté.