

Warum weisen die Dashboards der Anbieter eine Lösungsquote von 75 % aus, während Ihre Kundenzufriedenheitswerte sinken? Warum gehen Ihre Support-Teams immer noch in der Flut komplexer, erneut eröffneter Tickets unter?
Die Erklärung ist ganz einfach: Ihre Kundendienstmitarbeiter leisten keine gute Arbeit. Überhaupt nicht.
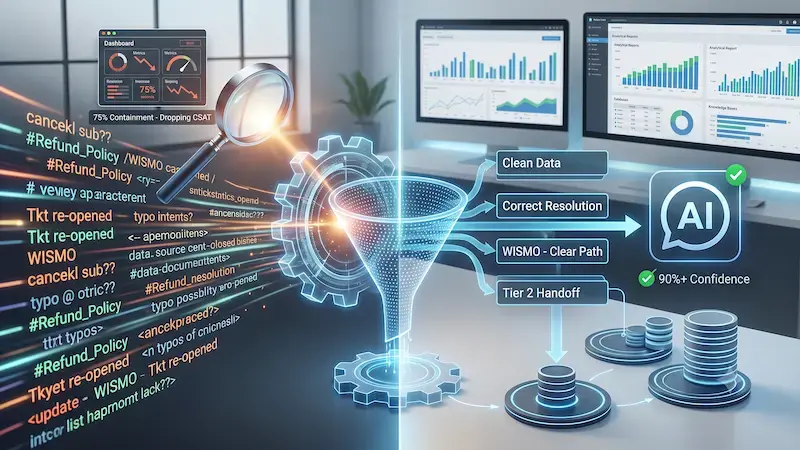 Es gibt einen enormen, kostspieligen Unterschied zwischen „Containment“ und echter Problemlösung. „Containment“ bedeutet lediglich, dass ein automatisiertes Tool einen Nutzer daran gehindert hat, einen menschlichen Mitarbeiter zu erreichen. Es bedeutet nicht, dass das System das Problem des Kunden tatsächlich gelöst hat.
Dieses Problem ist in modernen Support-Umgebungen weit verbreitet.
Marktdaten von Calabrio zeigen, dass mittlerweile bis zu 98 % der Kontaktzentren irgendeine Form von künstlicher Intelligenz in ihren Arbeitsabläufen einsetzen.
Allerdings
verfügen nur 12 % dieser Unternehmen über eine vollständig optimierte Datenstrategie, die dies unterstützt.
Darüber hinaus
berichten Gartner-Studien, dass zwar 91 % der Führungskräfte im Kundensupport unter starkem Druck der Geschäftsleitung stehen, automatisierte Tools einzusetzen, viele jedoch Schwierigkeiten haben, dem Vorstand die tatsächliche Genauigkeit der KI-Lösungen zuverlässig darzulegen.
Tatsächlich
geben fast 71 % der Führungskräfte im Kundenservice zu, dass sie ihre tatsächlichen autonomen Lösungsquoten gegenüber dem Vorstand nicht zuverlässig nachweisen können.
Dieser Mangel an Transparenz entsteht, weil manuelle Prüfungen oft zeigen, dass automatisierte Kennzahlen doppelt so gut aussehen wie die Realität, wenn wiederholte Kontakte oder versteckte Eskalationen nicht erfasst werden.
Sie können Ihre automatisierten Supportsysteme nicht optimieren, wenn Ihre Kundensupport-Daten unvollständig sind. Wenn Sie ein KI-System auf der Grundlage unordentlicher, ungeprüfter historischer Ticketprotokolle trainieren oder darauf basieren, sinkt die Leistung sofort. Das System übernimmt Ihre früheren Datenfehler. Um echte Effizienz zu erzielen, müssen Sie über einfache Ablenkungsstatistiken hinausblicken. Dieser ausführliche Leitfaden bietet ein strenges Rahmenwerk für die Prüfung Ihrer Gesprächsprotokolle, die Isolierung versteckter Fehler in Randfällen sowie die Bereinigung Ihrer zugrunde liegenden Supportdaten.
Was ist die KI-Lösungsgenauigkeit?
Um Ihre automatisierte Plattform zu optimieren, müssen Sie genau festlegen, was Sie messen. Die KI-Lösungsgenauigkeit ist der Prozentsatz aller Kundeninteraktionen, die ein KI-Agent beim ersten Versuch vollständig löst – ohne menschliches Eingreifen, ohne Fehlinformationen und ohne dass der Nutzer Ihr Team erneut kontaktieren muss.
Dies unterscheidet sich von der automatisierten Lösungsrate (ARR) oder der Ablenkungsrate, die Sie auf den Dashboards herkömmlicher Software sehen. Betrachten Sie folgende Formel: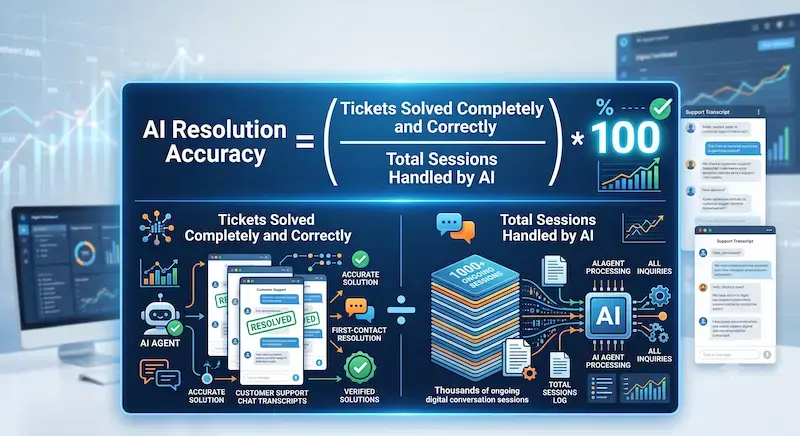 Standard-Softwareplattformen verzeichnen häufig eine erfolgreiche Umleitung, sobald ein Kunde ein Chat-Widget schließt. Aber hat dieser Kunde tatsächlich eine Antwort erhalten? Oder hat er das Fenster aus purer Frustration geschlossen? Echte Lösungsgenauigkeit erfordert eine echte Datenvalidierung. Sie bestätigt, dass die Absicht des Kunden genau, sicher und in voller Übereinstimmung mit Ihren aktuellen Geschäftsrichtlinien erfüllt wurde.
Warum „unsaubere“ Supportdaten die KI-Leistung verzerren
Kundensupportdaten sind von Natur aus chaotisch. Echte Kundentickets sind voll von Tippfehlern, komplexen Formatierungen, systemgenerierten Warnmeldungen und „Konversationsrauschen“. Kunden bündeln oft drei völlig unabhängige Anfragen in einem einzigen Textthread.
Wenn rohe, ungereinigte Textprotokolle in ein Large Language Model (LLM) oder eine Retrieval-Augmented-Generation-Wissensdatenbank (RAG) eingespeist werden, leidet die Leistung darunter. Die Automatisierung übernimmt veraltete Antworten, tote Weblinks und unsachgemäße Routinggewohnheiten der Mitarbeiter.
Es ist ganz einfach:
Unsaubere Support-Protokolle ➔ RAG-Wissenspipeline ➔ KI-Halluzinationen & falsche Lösungen
Das damit verbundene Unternehmensrisiko ist messbar.
Ein Branchenbericht von RevSure zeigt, dass 49 % der Führungskräfte Datenungenauigkeiten und strukturelle Verzerrungen als die Haupthindernisse für die erfolgreiche Skalierung agentenbasierter KI nennen.
Eine schlechte Datenhygiene zwingt Unternehmen zudem dazu, fortgeschrittene Funktionen gänzlich aufzugeben.
Untersuchungen von Gartner zeigen, dass Unternehmen bis 2026 bis zu 60 % ihrer KI-Projekte aufgrund fehlender „KI-fähiger“ Daten aufgeben werden.
Wenn Ihre zugrunde liegenden Supportdaten strukturelle Mängel aufweisen, wird auch Ihre automatisierte Logik nicht funktionieren.
Das 4-Stufen-Konzept zur Überprüfung und Bereinigung von Kundensupport-Daten
Sie können diese Leistungsprobleme systematisch beseitigen. Nutzen Sie dieses vierstufige Rahmenkonzept, um Ihre aktuellen Transkripte zu prüfen, fehlerhafte Daten zu bereinigen und Ihr automatisiertes Kundenerlebnis zu sichern. Auf diese Weise können Ihre zielorientierten Kundenbetreuer ihre Ziele tatsächlich erreichen.

Schritt 1: Ermitteln Sie Ihre „Ground Truth“ durch manuelle Überprüfung der Transkripte
Sie können ein automatisiertes System nicht reparieren, ohne eine klare Vorstellung davon zu haben, wie eine perfekte Antwort aussieht. Sie müssen einen „Ground Truth“-Datensatz aufbauen. Dabei handelt es sich um eine kuratierte Sammlung verifizierter Kundenanfragen, die jeweils mit ihrer exakten, idealen Lösung verknüpft ist.
Beginnen Sie damit, eine Zufallsstichprobe von 500 aktuellen autonomen Kundeninteraktionen zu ziehen. Schauen Sie nicht nur darauf, ob der Ticketstatus als „geschlossen“ markiert ist. Lesen Sie den Gesprächstext direkt durch. Achten Sie genau auf diese drei versteckten Fehlerquellen:
-
Stilles Abbrechen: Der Kunde hat vollständig aufgehört zu antworten, weil die automatisierten Antworten verwirrend, zirkulär oder repetitiv waren. Er ist ohne Lösung gegangen.
-
Die Richtlinien-Schleife: Das System hat eine allgemeine Unternehmensrichtlinie korrekt wiedergegeben, versäumt jedoch, auf die spezifische, praktische Ausnahme einzugehen, auf die der Nutzer gebeten hat. Dadurch bleibt das Kernproblem ungelöst.
-
Die erneute Kontaktaufnahme innerhalb von 24 Stunden: Das System hat die Chat-Sitzung ordnungsgemäß beendet, doch der Kunde hat innerhalb dieser Frist ein identisches E-Mail- oder Telefon-Ticket eröffnet, da die ursprüngliche Antwort nicht ausgereicht hat.
Die Dokumentation dieser Fehler hilft Ihnen dabei, zu ermitteln, wo Ihr Verständnis Ihres Systems in realen Szenarien versagt. Wenn Sie diese Trends aufdecken, können Sie deutlich die Kluft erkennen zwischen dem, was Ihr Dashboard als„Ablenkung“ bezeichnet, und dem, was Ihr Kunde als„Versagen“ bezeichnet.
Schritt 2: Bereinigen und entstören Sie Ihre historischen Supportdaten
Sobald Sie die häufigen Systemfehler verstanden haben, müssen Sie Ihre Datenbank bereinigen. Dieser Prozess wirkt wie eine Waschmaschine für Ihre Kundensupportdaten, bevor sie in Ihre Live-Automatisierungs-Engine eingespeist werden. Stellen Sie sich das so vor, als würden Sie das Rauschen entfernen, damit das Modell das Signal erkennen kann.
|
Datenproblem |
Visuelle Darstellung in den Protokollen |
Technische Bereinigungsmaßnahme |
|---|---|---|
|
Intent-Überschneidungen |
Sich überschneidende Tags wie #Refund_Policy und #Return_Instructions verwirren das Modell. |
Identische Kategorien zu einer einzigen, sich gegenseitig ausschließenden Intent-Map zusammenführen. |
|
Veralteter Kontext |
Veraltete Preisstrukturen, nicht mehr funktionierende Plattform-Links oder abgelaufene Produktdokumentationen. |
Entfernen Sie veraltete Dateien vollständig aus Ihren RAG-Wissensverzeichnissen. |
|
Systemtext-Rauschen |
Interne CRM-Automatisierungsmeldungen, wie z. B. „Ticket in die Tier-2-Warteschlange verschoben“ in den Benutzerprotokollen. |
Führen Sie automatisierte Skriptfilter aus, um interne Systemmetadaten zu entfernen. |
Durch die Bereinigung dieser Datensätze stellen Sie sicher, dass Ihr System ausschließlich auf korrekte und aktuelle Informationen zurückgreift. Dies minimiert das Risiko, Kunden mit widersprüchlichen Antworten zu belasten.
Tatsächlich zeigen technische Auswertungen von Atlan, dass
die Verankerung Ihrer Modelle in einem äußerst sauberen, gut gepflegten RAG-Framework die Halluzinationsrate im Vergleich zu nicht verankerten Systemen um bis zu 85 % senken kann.
Schritt 3: Ungenauigkeiten in Randfällen isolieren und klassifizieren
Einfache Kundenanfragen lassen sich leicht automatisieren.
Standardanfragen wie „Wo ist meine Bestellung?“ (WISMO) machen laut WISMO in der Regel 35 % bis 40 % des gesamten Supportvolumens im Online-Handel aus.
Automatisierte Systeme bewältigen diese Basisaufgaben mühelos, da sie direkt mit vorhersehbaren API-Datenströmen verbunden sind. Der wahre Test für die Genauigkeit Ihrer KI-Lösungen liegt in den verbleibenden 60 % komplexer, seltener Kundenszenarien.
Wenn Sie bei Ihrer Datenprüfung einen automatisierten Fehler entdecken, ordnen Sie ihn einer dieser drei spezifischen operativen Kategorien zu:
-
Kontextuelle Fehlzuordnung: Der automatisierte Agent hat ein entscheidendes Detail in der Nachricht des Nutzers übersehen, etwa indem er eine Stornierungsanfrage mit einer Anfrage zur vorübergehenden Unterbrechung verwechselt hat.
-
Wissenslücken: Die genauen Informationen, die zur Lösung des Problems des Nutzers erforderlich waren, wurden in Ihren offiziellen Knowledge-Base -Artikeln nie dokumentiert. Die KI war gezwungen, zu raten.
-
Versagen der Sicherheitsvorkehrungen: Das System hat einen unpassenden Gesprächsstil gewählt, unbestätigte Gerüchte über Produktaktualisierungen weitergegeben oder unbefugte Ratschläge zu Transaktionen gegeben.
Die Kategorisierung Ihrer Fehler hilft Ihnen, technische Korrekturen zielgerichtet vorzunehmen. Anstatt zu erraten, warum das System versagt hat, können Sie genau feststellen, welches Modul, welche Eingabeaufforderung oder welcher Artikel den Ausfall verursacht hat. Dies erspart Ihrem Entwicklungsteam stundenlange, ziellose Fehlersuche.
Schritt 4: Setzen Sie vertrauensbasierte Triage-Kontrollen ein
Sie müssen Ihre automatisierte Plattform nicht dazu zwingen, jedes einzelne Ticket zu lösen. Dies führt unweigerlich zu Frustration bei den Kunden. Nutzen Sie stattdessen vertrauenswürdige Echtzeitdaten, um ein dynamisches Triage-Framework aufzubauen. Die meisten fortschrittlichen Dialog-Engines berechnen für jede von ihnen generierte Antwort einen internen Wahrscheinlichkeitswert, der darauf basiert, wie gut die Nutzer-Eingabe mit den vorhandenen Daten übereinstimmt.
-
Vertrauenswürdigkeit der Antwort berechnen: Das System gleicht den eingehenden Kundentext mit seinen verfügbaren Wissensdaten ab und weist ihm einen Präzisionswert in Prozent zu.
-
Automatisierung bei hoher Zuverlässigkeit ausführen: Liegt der berechnete Wert deutlich über 90 %, sendet das System die Antwort sofort und löst das Problem ohne menschliches Eingreifen.
-
Entwürfe mit mittlerer Zuverlässigkeit weiterleiten: Liegt der Wert zwischen 70 % und 90 %, erstellt das System einen Antwortentwurf und leitet ihn zur Überprüfung, Bearbeitung und Freigabe an einen menschlichen Mitarbeiter weiter, bevor der Kunde ihn sieht.
-
Bei geringer Zuverlässigkeit eine Weiterleitung auslösen: Liegt der Wert unter 70 %, umgeht das System die Automatisierung vollständig und leitet den Kunden nahtlos mit dem gesamten Kontext an einen menschlichen Mitarbeiter weiter.
Dieser Triage-Ansatz gewährleistet, dass Sie eine hohe Qualität aufrechterhalten. Indem Sie bei mehrdeutigen Anfragen einen Menschen in den Prozess einbeziehen, verhindern Sie, dass die KI in der Öffentlichkeit mit hoher Sicherheit Fehler begeht.
Umwandlung von Audit-Erkenntnissen in Leitplanken für Prompts
Sobald Sie Ihre zentralen Datenlücken identifiziert haben, müssen Sie Ihre Grundmodelle nicht von Grund auf neu trainieren. Ein erneutes Training ist kostspielig und zeitaufwendig. Passen Sie stattdessen die Prompt-Leitplanken und Systemanweisungen an, die das tägliche Verhalten Ihres Live-Agenten steuern.
Implementieren Sie strenge negative Einschränkungen in Ihre System-Prompts. Weisen Sie das System genau an, was es nicht tun oder sagen darf. Diese Grenzen verhindern, dass das Modell sich kreative Freiheiten bei Ihren Unternehmensrichtlinien nimmt. Sie können beispielsweise eine präzise operative Anweisung wie diese in Ihre System-Kernparameter einfügen:
„Wenn ein Kunde darum bittet, ein Unternehmensabonnement zu ändern, dürfen Sie niemals die Standardpreise für Privatkunden nennen. Leiten Sie die Interaktion unverzüglich an das Account-Management-Team weiter.“
Konzentrieren Sie Ihre Optimierungsbemühungen zudem direkt auf Ihre Quelldokumentation. Wenn ein automatisierter Agent eine falsche Antwort zu Ihrem Garantieprozess liefert, liegt die Ursache fast immer an einem mehrdeutigen, verwirrenden oder veralteten Hilfeartikel. KI-Agenten erfinden nichts aus dem Nichts; sie verstärken lediglich die Widersprüche, die bereits in Ihren Unterlagen enthalten sind. Wenn Sie den Text der Quelldokumentation bereinigen, verbessert sich die Genauigkeit der Live-KI-Lösungen automatisch.
Kontinuierliche Qualitätssicherung für langfristigen Erfolg
Die Datenbereinigung ist niemals ein einmaliges Projekt. Sie ist eine fortlaufende operative Gewohnheit. Ihre internen Produktkataloge werden aktualisiert, Ihre Unternehmenssoftware-Tools entwickeln sich weiter und das tatsächliche Kundenverhalten verändert sich im Laufe der Zeit. Wenn Sie Datenhygiene als einmaligen Meilenstein betrachten, wird sich die Genauigkeit Ihrer Automatisierung innerhalb von drei bis sechs Monaten verschlechtern.
Etablieren Sie einen strukturierten, kontinuierlichen Qualitätsrhythmus. Lassen Sie Ihre Qualitätsmanager im Support lediglich 5 % ihrer Arbeitszeit für die Überprüfung automatisierter Interaktionen mit geringer Zuverlässigkeit aufwenden.
Dieser fortlaufende Überprüfungsprozess schafft einen kontinuierlichen Optimierungszyklus, der Ihre Marke schützt:
Randfall-Fehler identifizieren ➔ Support-Quelldaten bereinigen ➔ Leitplanken für Prompts anpassen ➔ Genauigkeit der Problemlösung steigern
Diese kontinuierliche Verfeinerung stellt sicher, dass Ihre automatisierten Systeme mit dem Wachstum Ihres Geschäftsbetriebs sicher skalieren. Dadurch wird die Qualitätssicherung von einer defensiven Kostenstelle zu einem proaktiven Wachstumsmotor für Ihre gesamte Kundenservice-Organisation.
Der strategische Weg zur vertrauenswürdigen Automatisierung
Der Aufbau eines erfolgreichen automatisierten Support-Systems erfordert mehr als nur die Einführung eines auffälligen neuen Software-Tools. Echte digitale Transformation erfordert:
-
Saubere Textdaten
-
Strukturierte Wissensdatenbanken
-
Ein diszipliniertes, kennzahlenorientiertes Audit-Framework.
Indem Sie der tatsächlichen Genauigkeit der KI-Lösungen Vorrang gegenüber irreführenden Kennzahlen zur Problembegrenzung einräumen, schützen Sie Ihre Kundenbeziehungen und skalieren gleichzeitig Ihre Abläufe effizient.
Die Umwandlung unübersichtlicher, veralteter Support-Protokolle in eine hochpräzise, automatisierte Engine erfordert technisches Fachwissen, Plattformkenntnisse und eine intensive operative Ausrichtung. Genau hier bietet Aspiration Marketing Ihrem Unternehmen entscheidenden Mehrwert.
Wir konzentrieren uns direkt auf Revenue Operations, umfassende Technologieintegrationen und Inbound-Service-Strategien. Wir unterstützen wachsende Unternehmen dabei, ihre historischen Supportdaten zu prüfen, komplexe Textpipelines aus Kundengesprächen zu bereinigen, interne Wissensdatenbanken zu strukturieren und zuverlässige „Human-in-the-Loop“-Workflows zu entwerfen.
Unsere Teams arbeiten eng mit Ihren Support-Verantwortlichen zusammen, um Spekulationen durch datengestützte Leitlinien zu ersetzen. Lassen Sie uns Ihnen dabei helfen, Ihre Rohdaten aus dem Kundensupport in eine leistungsstarke, automatisierte Ressource umzuwandeln, die echte Geschäftseffizienz, einen klaren ROI und dauerhafte Kundenbindung fördert.
Kommentar hinterlassen
Haben Sie Fragen oder Kommentare?
Teilen Sie Ihr Feedback, stellen Sie Fragen oder diskutieren Sie mit unserer Community.